Narzędzie · robots.txt i boty AI
Czy boty AI mogą czytać Twoją stronę?
robots.txt mówi botom, co im wolno. Sprawdź, czy mówi to, co myślisz.
Wpisz domenę albo wklej robots.txt. Zobaczysz, na co Twój plik pozwala 57 botom i tokenom z mojej listy: od GPTBota i ClaudeBota po nowy token __usage_ai-training, a dla porównania Googlebotowi i Bingbotowi. Do tego meta robots, X-Robots-Tag, TDMRep, Content-Signal i llms.txt, a przy każdym bocie wiersz pliku, który zdecydował.
Narzędzie w skrócie
z mojej listy botów: trening, wyszukiwarki AI, wizyty na prośbę użytkownika i tokeny bez własnego bota. Do porównania Googlebot i Bingbot.
logika i testy z otwartej biblioteki Google robotstxt: najdłuższa reguła wygrywa, przy remisie wygrywa Allow.
robots.txt, token __usage_ai-training, meta robots i X-Robots-Tag, TDMRep i Content-Signal. Do tego llms.txt.
pliki pobiera serwer, wynik liczy Twoja przeglądarka. Domen ani plików nie zapisuję.
Jak to działa
Co narzędzie sprawdza i jak liczy
Po wpisaniu domeny serwer podrez.pl pobiera cztery publiczne pliki: /robots.txt, stronę główną (same nagłówki i <head>), /llms.txt i /.well-known/tdmrep.json. Resztę liczy Twoja przeglądarka. Możesz też wkleić robots.txt, wtedy plik nie wychodzi z komputera.
Plik czytam tak, jak Google: według RFC 9309 i otwartej biblioteki robotstxt, z której przeniosłam też testy. Bot szuka grupy ze swoją nazwą. Jeśli jej nie ma, bierze grupę *. Gdy do adresu pasuje kilka reguł, wygrywa najdłuższa, a przy remisie Allow. Grupy z tą samą nazwą się łączą, a Google czyta tylko pierwsze 500 KiB pliku.
Niektóre boty mają regułę zapasową. Google-CloudVertexBot i Googlebot-News bez własnej grupy stosują reguły dla Googlebota. Wspólny token __usage_ai-training nie decyduje o dostępie, tylko wyraża sprzeciw wobec treningu. Anthropic uwzględnia go od 30 października 2026 (wdraża stopniowo), gdy plik nie ma grupy ClaudeBot, więc przy ClaudeBocie pokazuję go osobno, pod wynikiem. Sam __usage_ai-training nie podlega grupie *: bez własnej grupy strona nie wyraża preferencji.
Przy każdym bocie zobaczysz wiersz, który zdecydował, a w testerze sprawdzisz dowolny adres i dowolny user-agent. To ta funkcja, którą Google wycofało z Search Console w grudniu 2023 roku. Zostały raport robots.txt i sprawdzanie adresu URL, które pokazuje blokadę tylko dla Googlebota.
Wynik
Co znaczą statusy
Może czytać
Twój robots.txt pozwala botowi pobrać sprawdzany adres. Wyjątki wspólne dla wszystkich botów, np. /wp-admin/, pokazuję jako uwagę pod botem. Przy tokenach: „Bez sprzeciwu”.
Częściowo
Reguły tylko dla tego bota zamykają mu część adresów albo otwierają tylko część strony. Lista pod botem. Przy tokenach: „Częściowy sprzeciw”.
Zablokowany
Twój robots.txt prosi bota, żeby nie pobierał tego adresu. Żadna reguła go nie otwiera. Przy tokenach: „Sprzeciw”. Gdy robots.txt zwraca błąd serwera (5xx albo 429), zobaczysz „Zablokowany (błąd serwera)”.
Brak preferencji
Tylko __usage_ai-training: plik nie ma dla niego grupy, a grupa * go nie obejmuje. Strona nie mówi ani tak, ani nie.
Nie dotyczy
Operator nie podaje nazwy do robots.txt (np. ChatGPT-User). Plik go nie zatrzyma, odciąć go można tylko na serwerze.
Statusy pokazują, o co prosi Twój robots.txt, a nie co bot naprawdę zrobi. Zapora serwera albo ustawienia Cloudflare potrafią odsyłać boty, którym plik pozwala wejść. Wtedy tu zobaczysz „Może czytać”, a bot dostanie 403 albo 429. Sprawdzisz to w logach.
Wpisz domenę, a sprawdzę stronę główną. Wpisz pełny adres podstrony, a sprawdzę tę podstronę. Inny adres wpiszesz też w testerze niżej i przeliczysz dla niego całą tabelę.
Sygnały dla AI
Allow i Disallow to nie wszystko
__usage_ai-training. Wspólny token przeciw trenowaniu AI, zapowiedziany 30 października 2026 przez Google, Microsoft, OpenAI i Anthropic. Kto i od kiedy go stosuje, opisuję we wpisie o __usage_ai-training.- Google-Extended. Zgoda na trening Gemini i grounding, czyli odpowiedzi Gemini oparte na Twojej stronie, w aplikacjach Gemini i w Vertex AI. Jego blokada nie usuwa strony z AI Overviews ani z AI Mode. Służy do tego ustawienie w Search Console (Ustawienia → Generatywna AI w wyszukiwarce, od 31 sierpnia 2026). Na poziomie strony udział w AI Overviews ograniczysz dyrektywami
nosnippet,max-snippetalbonoindex. - Bing. Od 1 lutego 2027 Microsoft czyta osobno trening (
ai-training) i grounding (ai-grounding) w meta tagu albo nagłówku X-Robots-Tag. Do 1 marca 2027 czyta teżnoarchiveinocachejako sprzeciw wobec obu. Narzędzie pokazuje oba ustawienia. - TDMRep. Zastrzeżenie eksploracji tekstu i danych z art. 4 dyrektywy UE 2019/790: plik
tdmrep.json, nagłówek albo meta tag. To raport grupy W3C Community Group, nie standard W3C. - Content-Signal i Content-Usage. Deklaracje w robots.txt: pierwsza od Cloudflare, druga ze szkicu IETF. Pokazuję, której grupy dotyczą, bo pusty wiersz nie zamyka grupy, a deklaracja potrafi trafić do innego bota, niż chciał autor.
- llms.txt. Sprawdzam, czy jest, jaki ma status, tytuł i linki, podobnie jak eksperymentalny audyt Lighthouse „Agentic Browsing”. Google Search go nie używa. Więcej we wpisie o pliku llms.txt.
Zanim wyciągniesz wnioski
robots.txt to prośba, a nie dyrektywa
Uczciwe boty się do niego stosują. Podszyte i złośliwe nie. Część botów na prośbę użytkownika (np. ChatGPT-User czy Perplexity-User) według swoich operatorów może pominąć robots.txt, a roboty Google, które pobierają kanały RSS, ignorują go w ogóle. Narzędzie pokazuje przy nich, co deklaruje operator.
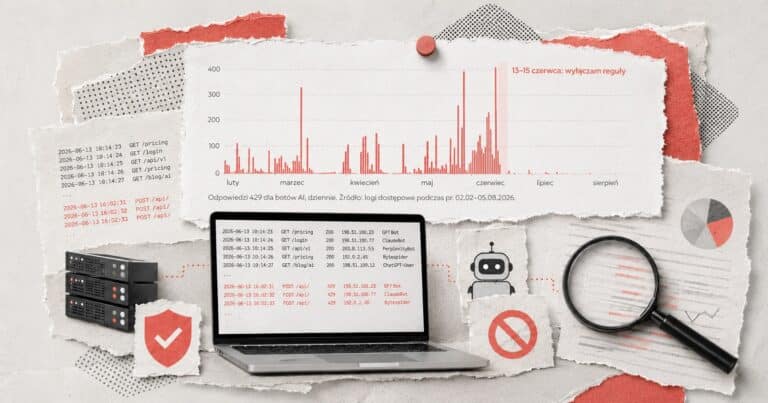
Co boty naprawdę robią na Twojej stronie, pokażą logi serwera. Do tego mam osobne narzędzie: Boty AI w logach.
Prywatność
Co się dzieje z wpisaną domeną
Pliki pobiera serwer podrez.pl, więc sprawdzana strona nie widzi Twojego adresu IP, tylko mój serwer i nazwę narzędzia w user-agencie. Serwer łączy się tylko z adresami publicznymi, a za przekierowaniami idzie najwyżej pięć razy. Nie zapisuje domen ani treści plików. Do limitów trzyma przez najwyżej dobę skróty (HMAC) Twojego adresu IP, sieci i sprawdzanej domeny, a nie same wartości.
Wklejony robots.txt zostaje w przeglądarce. Jego treść nie wychodzi do sieci.
Co mierzę. Google Analytics dostaje tylko informację, że ktoś użył narzędzia: w jakim trybie (domena, wklejony plik, przykład), z jakim typem odpowiedzi robots.txt (np. „2xx” albo „5xx”), z jakim kodem błędu, jeśli coś nie zadziałało, oraz czy tester sprawdzał bota z listy albo wpisanego ręcznie i czy wyszło „wolno”, czy „nie wolno”. Bez domeny, adresu i user-agenta, zgodnie z Twoimi ustawieniami ciasteczek.
Zanim coś zmienisz
Co zrobić z wynikiem
- Nie chcesz treningu, ale chcesz być w wyszukiwarkach AI. Zablokuj boty z grupy „Trenowanie modeli” (GPTBot, ClaudeBot, CCBot, meta-externalagent, Bytespider i inne), tokeny Google-Extended i Applebot-Extended oraz dodaj grupę
__usage_ai-training. Wyszukiwarki AI (OAI-SearchBot, Claude-SearchBot, PerplexityBot) zostaw otwarte. Co modele mają już w pamięci, pokazuje ich data odcięcia wiedzy (zestawiam te daty w tabeli Cutoff modeli AI). - Chcesz zniknąć z AI Overviews. Google-Extended tego nie załatwi. Najprościej przełączyć w Search Console ustawienie Generatywna AI w wyszukiwarce (Ustawienia). Wyklucza witrynę z AI Overviews, AI Mode i funkcji AI w Discover, bez wpływu na zwykłe wyniki. Pojedyncze strony ograniczysz
nosnippetalbomax-snippet, ale to skraca też ich opis w zwykłych wynikach. - Wszystko zablokowane, choć nie miało być. Szukaj
Disallow: /w grupie*. To częsta pamiątka po wersji testowej strony. - robots.txt zwraca błąd 5xx. Google przez pierwsze 12 godzin nie pobiera strony, potem do 30 dni korzysta z ostatniej dobrej kopii pliku. Napraw serwer, zanim zaczniesz poprawiać reguły.
- „Może czytać”, a bota nie ma w logach albo dostaje 403 lub 429. To nie robots.txt, tylko serwer. Zapytaj hosting o zaporę (WAF) albo sprawdź ustawienia botów w Cloudflare. Mój hosting kiedyś po cichu włączył zaporę, która odsyłała boty AI kodem 429. robots.txt wpuszczał wszystkie, a zobaczyłam to dopiero w logach.
- Uwagi do pliku. Literówki w nazwach dyrektyw i brak dwukropka Google wybacza, inne boty niekoniecznie. Wszystkie boty pomijają reguły przed pierwszym User-agent i wzorce bez ukośnika. Lepiej je poprawić.
- U siebie wpuszczam wszystkie boty AI i nie dodaję
__usage_ai-training. Zależy mi na widoczności w odpowiedziach AI, więc to świadoma decyzja, a nie przeoczenie.
Narzędzia i listy
Inne moje narzędzia i listy
Darmowe i bez logowania. Każde odpowiada na jedno konkretne pytanie.

Narzędzie
Obserwatorium encji
Zobacz dane strukturalne strony jako mapę relacji i dołóż obok rekord z Wikidaty.

Narzędzie
Czy jesteś w Grafie Wiedzy Google?
Wpisz nazwę i sprawdź, czy Google zna Cię jako encję i czy zgadza się to z Wikidatą.
Narzędzie
Czy strona jest w Common Crawl?
Sprawdź, ile Twoich stron trafiło do archiwum Common Crawl i czy coś nie blokuje CCBota.

Narzędzie
Boty AI w logach
Wrzuć log serwera i zobacz, które boty AI naprawdę przychodzą i czy serwer któregoś nie odsyła.
Narzędzie
Kto wpisał te zapytania w Search Console?
Wrzuć eksport z Search Console i zobacz, które zapytania wyglądają na prompty, operatory i footprinty narzędzi.
Wyszukiwarka
Lista botów i user-agentów
Wyszukiwarka botów: kto za nimi stoi, do czego służą i jak je ustawić w robots.txt.
Plik robots.txt to deklaracja. Jak serwer odpowiada botom, które udają GPTBota czy ClaudeBota, możesz sprawdzić w High Five, AI! by Maciej Chmurkowski.
Do poczytania
Wpisy o botach AI, robots.txt i llms.txt
Często zadawane pytania
Jak sprawdzić, czy GPTBot może czytać moją stronę?
Czy to tester robots.txt?
Jak zablokować trenowanie AI, a zostać w wyszukiwarkach AI?
User-agent: GPTBot i Disallow: /), dodaj tokeny Google-Extended i Applebot-Extended oraz grupę __usage_ai-training z Disallow: /. Boty wyszukiwarek AI, takie jak OAI-SearchBot, Claude-SearchBot czy PerplexityBot, zostaw otwarte. Po zmianie sprawdź plik tym narzędziem.Czy blokada Google-Extended usuwa stronę z AI Overviews?
nosnippet, max-snippet albo noindex.Czym jest __usage_ai-training?
* go nie obejmuje: jeśli nie dodasz dla niego osobnej grupy, strona nie wyraża preferencji. To sprzeciw wobec treningu, a nie blokada: o tym, czy bot w ogóle wchodzi, nadal decydują reguły dla jego nazwy albo grupa *. Szczegóły i daty wdrożeń: wpis o __usage_ai-training.Czy robots.txt naprawdę zatrzymuje boty?
Dlaczego przy ChatGPT-User jest „Nie dotyczy”?
Co znaczy status „Częściowo”?
/wp-admin/ czy wyniki wyszukiwania w grupie *, nie zmieniają statusu. Pokazuję je jako uwagę pod botem.Czy llms.txt jest potrzebny?
Czym to się różni od testera robots.txt w Search Console?
Ile razy mogę sprawdzać?
Czy zapisujesz sprawdzane domeny?
Dane: moja lista botów (stan z 8 listopada 2026). Parser: przeniesiony z otwartej biblioteki Google robotstxt (Apache License 2.0) razem z jej testami. Narzędzie nie jest powiązane z Google, Microsoftem, OpenAI, Anthropic ani Cloudflare.
Co dalej
Nie wiesz, które boty wpuścić?
Trening, wyszukiwarki AI, wizyty na prośbę użytkownika i zwykłe wyszukiwarki to cztery różne decyzje. Pomagam je podjąć tak, żeby nie stracić widoczności tam, gdzie jej potrzebujesz.
Wolisz najpierw porozmawiać?
W bezpłatnych 15 minutach ustalimy, co warto ustawić w pierwszej kolejności.
Zgłoszenia
Coś nie działa albo masz pomysł?
Narzędzia buduję sama i poprawiam je na bieżąco, więc każde zgłoszenie się przydaje. Napisz, co się stało albo czego Ci brakuje. Przy błędzie dopisz przeglądarkę i urządzenie (telefon albo komputer), wtedy szybciej go znajdę.