Stan na 1 listopada 2026 · Google, Microsoft i OpenAI zapowiedziały obsługę, Anthropic ją wdraża
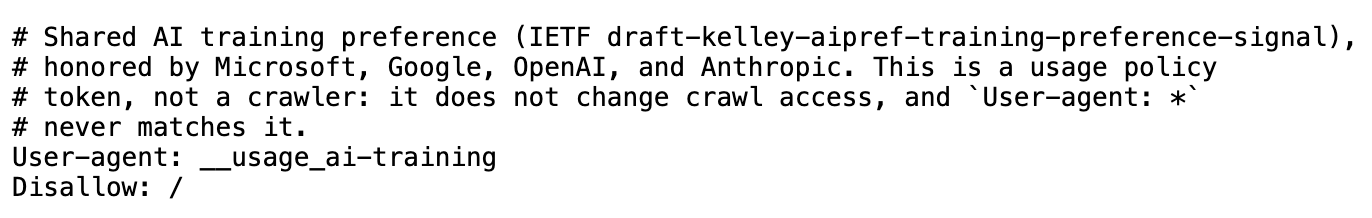
W piątek 30 października 2026 Google, Microsoft i OpenAI ogłosiły, że będą respektować jedną wspólną regułę w pliku robots.txt. Reguła ta mówi wprost: nie używaj moich treści do trenowania modeli generatywnej AI. Zamiast osobnych wpisów dla GPTBota, Google-Extended czy ClaudeBota mają wystarczyć dwie linijki:
User-agent: __usage_ai-training
Disallow: /
Co ważne, nie mówimy o nowym bocie czy regule dostępu. Zapis nie zmienia tego, kto może skanować stronę, nie usuwa jej z Google ani z Binga i nie wyłącza AI Overviews. W zasadzie na razie… nikt nie potwierdził, że już go respektuje. Microsoft zacznie 1 lutego 2027, Google „na początku 2027”, OpenAI „w najbliższych miesiącach”, a Anthropic rozpoczęło wdrożenie, ale nie podało terminu.
| Co zapowiedziano? | Od kiedy | |
|---|---|---|
| Reguła działa jak blokada Google-Extended (trenowanie Gemini i grounding w aplikacjach Gemini), chyba że Google-Extended ma własną grupę. Wyszukiwarka bez zmian. | początek 2027 | |
| Microsoft | Reguła w robots.txt, ta sama preferencja dla pojedynczych stron (meta tag i nagłówek HTTP) oraz osobne ustawienie groundingu. NoArchive i NoCache przestaną sterować trenowaniem i groundingiem. | od 1 lutego 2027, w miarę ponownego skanowania |
| OpenAI | Obsługa wspólnej reguły. Dotychczasowe ustawienia dla robotów OpenAI w robots.txt nadal obowiązują. | „w najbliższych miesiącach” |
| Anthropic | Autorem szkicu jest Kevin Kelley z Anthropic. Według jego wiadomości na liście IETF firma zaczęła wdrożenie, ale strona pomocy nadal opisuje tylko ClaudeBota, Claude-User i Claude-SearchBota. | brak daty |
Żadna z firm nie potwierdziła jeszcze, że reguła już działa. Google, OpenAI i Anthropic zapowiadają, że dotychczasowe ustawienia dla ich robotów zostają. Microsoft zmienia tylko znaczenie NoArchive i NoCache. W ogłoszeniach nie ma Apple ani Meta, więc Applebot-Extended czy meta-externalagent trzeba na razie blokować osobno.
Jak działa __usage_ai-training?
Do tej pory każdy dostawca miał własną nazwę: GPTBot, Google-Extended, Applebot-Extended, ClaudeBot, meta-externalagent. Lista rosła, a pełna blokada trenowania wymagała znajomości wszystkich nazw (prowadzę ich listę w zestawieniu Co to za bot?). Szkic Kevina Kelleya zbiera to w jeden wpis i nie wymaga przy tym żadnej nowej składni. Używa zwykłej grupy User-agent, tylko zamiast nazwy robota wpisuje się tzw. token polityki (policy token). Parsery, które go nie znają, po prostu go pominą.
- 1
Gwiazdka go nie obejmuje
Grupa
User-agent: *nigdy nie dotyczy tokenu. DotychczasoweDisallowdla wszystkich robotów nie jest więc odczytywane jako sprzeciw wobec trenowania. - 2
Brak grupy to brak zdania
Jeśli w robots.txt nie ma grupy
__usage_ai-training, strona nie wyraża żadnej preferencji. Microsoft przyjmuje wtedy domyślną wartośćAllow. - 3
Działa na ścieżki
DisallowiAllowdziałają jak zwykle, wygrywa dłuższe dopasowanie. Można zablokować cały serwis i zostawić otwarty np. katalog z materiałami prasowymi. - 4
Nie steruje skanowaniem
To deklaracja o użyciu treści, nie o dostępie. Żeby robot w ogóle nie wchodził, nadal potrzebne są reguły dla jego nazwy. Szkic dopuszcza jednak, że firma nie pobierze treści, której i tak nie może użyć.
Trenowanie jest tu zdefiniowane wąsko: to zmiana parametrów modelu generatywnego na podstawie treści. Modele, które wyłącznie klasyfikują albo układają ranking, się nie liczą. Definicja pochodzi ze słownika grupy roboczej AI Preferences (AIPREF) w IETF.
Warto wiedzieć
To na razie indywidualny szkic (Internet-Draft) w wersji 00 z 30 października 2026, a nie standard. IETF zaznacza, że go nie zatwierdziło, a szkic wygasa 3 maja 2027, jeśli nikt go nie zaktualizuje. Składnia może się więc jeszcze zmienić. Microsoft obiecuje, że o zmianach uprzedzi z wyprzedzeniem.
Microsoft idzie dalej: osobno trenowanie, osobno grounding
Bing dokłada do wspólnej reguły dwie własne rzeczy. Pierwsza: preferencję trenowania można ustawić dla pojedynczej strony meta tagiem albo nagłówkiem HTTP i wtedy wygrywa ona z robots.txt. Druga to osobne ustawienie groundingu, czyli tego, czy strona może zasilać odpowiedzi AI w Bingu, w Copilocie i w Microsoft 365. Grounding ustawia się wyłącznie na poziomie strony, w robots.txt go nie ma.
Zakaz trenowania dla jednej strony, meta tagiem albo nagłówkiem HTTP (wystarczy jedno z dwóch):
<meta name="Bingbot" content="ai-training:disallow">
X-Robots-Tag: Bingbot: ai-training:disallow
Grounding tylko w usługach Microsoftu, też w dwóch wariantach do wyboru. Zamiast disallowextended można wpisać disallow albo allow, znaczenie wartości opisuję niżej:
<meta name="Bingbot" content="ai-grounding:disallowextended">
X-Robots-Tag: Bingbot: ai-grounding:disallowextended
Allow
Ustawienie domyślne, nic nie trzeba dodawać. Treść może zasilać odpowiedzi AI, z linkami do źródła.
DisallowExtended
Grounding tylko w usługach Microsoftu (tryb AI w Bingu, Copilot, Microsoft 365), bez usług groundingu, które Microsoft udostępnia innym firmom, np. Web IQ czy API w Microsoft Foundry.
Disallow
Treść nie zasila odpowiedzi generowanych przez AI.
Microsoft zapewnia, że żadne z tych ustawień nie zmienia obecności w zwykłych wynikach Binga. O groundingu w Bingu i o tym, jak go mierzyć, pisałam przy raporcie AI Performance w Bing Webmaster Tools.
Jeśli używasz NoArchive albo NoCache
Te stare znaczniki przestaną w Bingu sterować trenowaniem i groundingiem. Gdy Microsoft wykryje w serwisie nowe ustawienia, NoArchive i NoCache przestają się dla niego liczyć jako sygnał dla AI. Kalendarz zmian:
- 115 grudnia 2026
W Bing Webmaster Tools rusza tymczasowe ustawienie groundingu. Dostaną je tylko strony, które tego dnia mają NoArchive albo NoCache.
- 21 lutego 2027
Microsoft zaczyna respektować nowe ustawienia, w miarę jak ponownie skanuje strony.
- 31 marca 2027
Termin na opublikowanie nowych ustawień i zapisanie tymczasowego w Bing Webmaster Tools. Potem NoArchive i NoCache nie będą już czytane jako sprzeciw wobec trenowania ani groundingu.
- 430 września 2027
Najpóźniej wtedy wygasają tymczasowe ustawienia groundingu. Dla danej strony wcześniej, jeśli Microsoft przy ponownym skanowaniu znajdzie na niej nowe ustawienie.
A co z AI Overviews i trybem AI w Google?
Do tego służy zupełnie inne ustawienie w Search Console, od 31 sierpnia 2026 dostępne dla wszystkich witryn. W ustawieniach usługi jest sekcja „Generatywna AI w wyszukiwarce” z dwiema opcjami:
Uwzględnij (domyślnie)
„Uwzględnij linki i treści z mojej witryny w funkcjach generatywnej AI w wyszukiwarce”. Strona może pojawiać się w przeglądach od AI, w trybie AI i w funkcjach AI w Discover (także jako link) oraz dostawać z nich wyświetlenia i ruch.
Wyklucz
„Wyklucz linki i treści z mojej witryny z funkcji generatywnej AI w wyszukiwarce”. Google nie pokaże strony w tych funkcjach i nie użyje jej do generowania odpowiedzi, więc wyświetleń i kliknięć z AI nie będzie wcale.
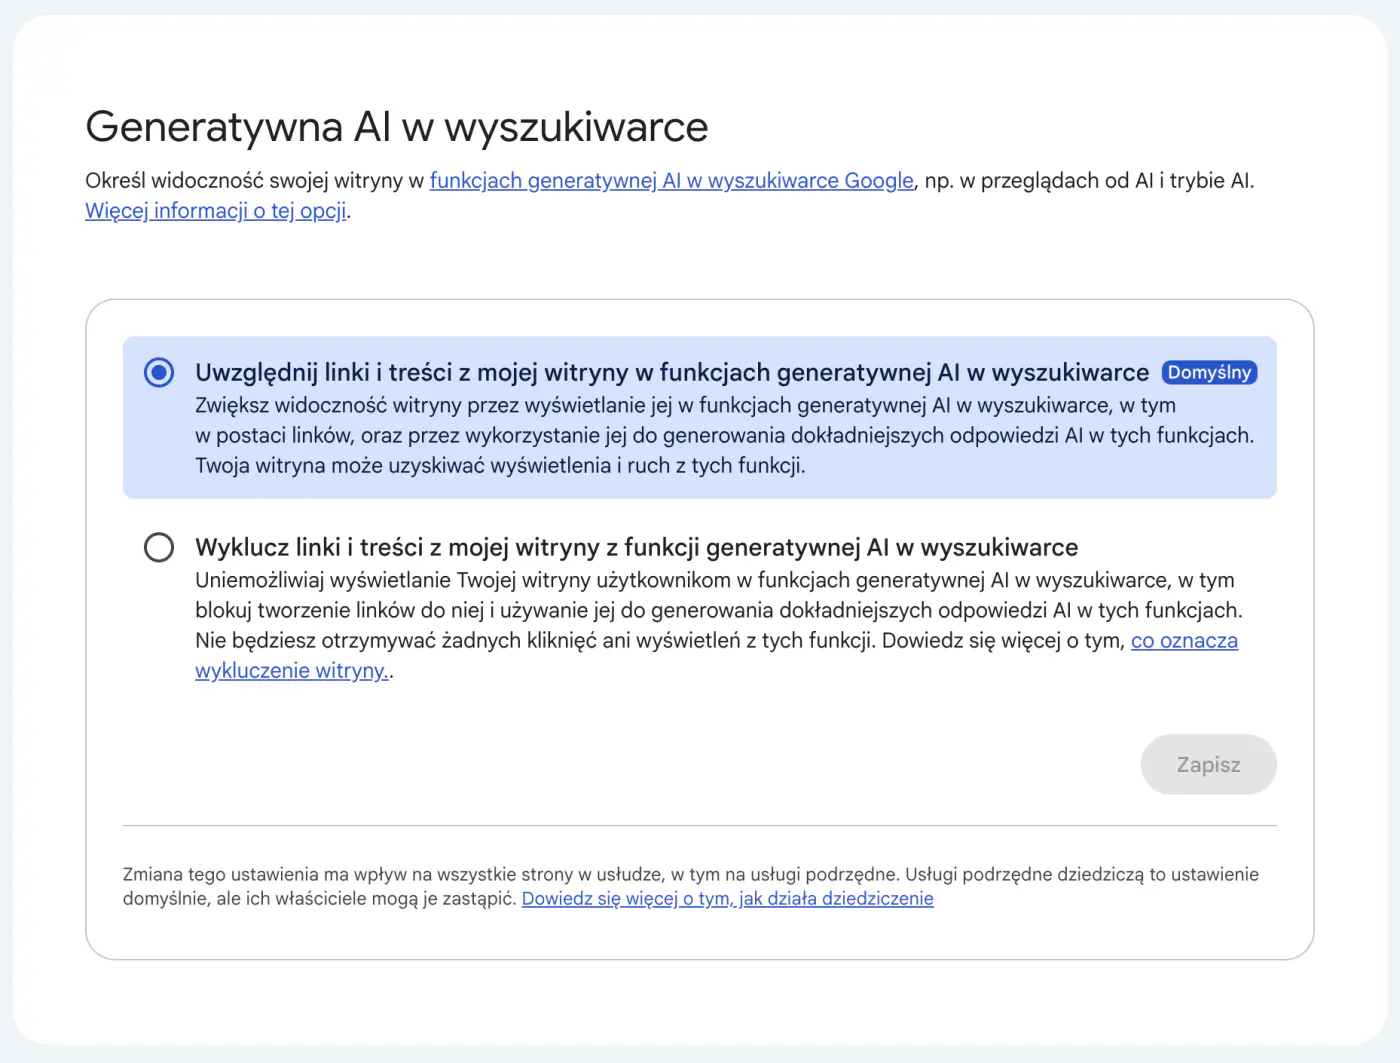
Ustawienie działa na całą usługę, łącznie z usługami podrzędnymi (te domyślnie je dziedziczą, ale ich właściciele mogą je zmienić). Według pomocy Search Console nie wpływa na pozycje w klasycznych wynikach, a zmiana zaczyna działać po 1–2 dniach. Opisywałam je razem z raportem Generatywna AI w Search Console. Warto zapamiętać jedno: przełącznik w Search Console nie dotyczy trenowania, a nowa reguła w robots.txt nie dotyczy AI Overviews.
Serwis X już to wdrożył
X ma tę regułę w robots.txt z komentarzem, że jest ona „honored by Microsoft, Google, OpenAI, and Anthropic”. Na dziś to raczej myślenie życzeniowe niż fakt: Google, Microsoft i OpenAI obsługę dopiero zapowiadają, a Anthropic jest w trakcie wdrożenia. Chyba że o czymś nie wiemy. Robots.txt X i tak niczego nie zostawia przypadkowi: osobno blokuje Google-Extended, FacebookBota i roboty Meta, a na końcu wszystkie pozostałe roboty grupą z gwiazdką.
Czy wstawiam tę regułę na podrez.pl?
Nie. Zajmuję się widocznością marek w AI i chcę, żeby modele mnie znały. To, co trafi do danych treningowych, może zostać w wiedzy bazowej modelu na długo, a moim zdaniem reputacja w tych danych buduje się podobnie jak w E-E-A-T, tylko z opóźnieniem. Nie traktuję tego jako gwarancji rozpoznawalności, ale świadomie nie wykluczam tego zastosowania. Dlatego na podrez.pl wpuszczam roboty AI, także te, które zbierają treści do trenowania. Więcej o tym, skąd modele biorą wiedzę o markach, pisałam we wpisie o Common Crawl.
Inaczej patrzyłabym na to jako wydawczyni treści płatnych, autorka zdjęć czy właścicielka serwisu, którego model biznesowy opiera się na wyłączności treści. Tam jedna reguła zamiast kilkunastu wpisów dla poszczególnych robotów to realna wygoda.
Co zrobić teraz?
- 1
Nic na siłę
Na razie żadna firma nie potwierdziła, że reguła już działa. Pierwszy konkretny termin to 1 lutego 2027 (Microsoft), OpenAI może być szybsze, a Anthropic jest w trakcie wdrożenia. Dotychczasowe wpisy dla GPTBota, ClaudeBota czy Google-Extended nadal obowiązują, a firmy zapowiadają, że tak zostanie.
- 2
Rozdziel trzy decyzje
Trenowanie (nowa reguła), odpowiedzi AI z groundingu (Google-Extended w Gemini, meta tag w Bingu) oraz wyniki wyszukiwania z AI Overviews (Googlebot, nosnippet i przełącznik w Search Console). To trzy różne ustawienia.
- 3
Sprawdź, kto naprawdę przychodzi
Zanim cokolwiek zablokujesz, zobacz w logach serwera, które roboty AI w ogóle odwiedzają stronę i czy są prawdziwe.
- 4
Zaplanuj zmianę NoArchive
Jeśli masz NoArchive albo NoCache i chcesz trzymać treść z dala od odpowiedzi AI w Bingu, zrób to przed 1 marca 2027.
Pytania o __usage_ai-training
Czy __usage_ai-training usunie moją stronę z ChatGPT albo z AI Overviews?
Nie. Reguła dotyczy trenowania modeli. AI Overviews i tryb AI w Google ustawia się przez Googlebota, nosnippet albo przełącznik w Search Console, a grounding w Bingu osobnym meta tagiem. Wyjątek to Google: tam reguła działa jak blokada Google-Extended (jeśli nie określono osobnych reguł dla Google-Extended), więc obejmuje też odpowiedzi w aplikacjach Gemini.
Czy wystarczy User-agent: * z Disallow: /?
Nie. Grupa z gwiazdką nigdy nie obejmuje tokenu __usage_ai-training, więc nie jest odczytywana jako sprzeciw wobec trenowania. Do tego blokuje wszystkie roboty, które nie mają w robots.txt własnej grupy, czyli zwykle także Googlebota i Bingbota.
Od kiedy reguła działa?
Na 1 listopada 2026 żadna firma nie potwierdziła, że już ją respektuje. Microsoft zacznie 1 lutego 2027, Google na początku 2027, OpenAI zapowiada wdrożenie w najbliższych miesiącach, a Anthropic rozpoczęło implementację, ale nie podało terminu.
Czy to oficjalny standard?
Nie. To indywidualny szkic IETF w wersji 00 z 30 października 2026, którego IETF nie zatwierdziło. Składnia może się jeszcze zmienić.
Źródła
Google Search Central Blog, John Mueller, Supporting a shared AI training control for websites (30.10.2026). Google, dokumentacja Google-Extended, pomoc Search Console Ustawienia generatywnej AI w wyszukiwarce.
Microsoft Bing Blog, Krishna Madhavan, Your content, your choice: clearer preferences for training and grounding (30.10.2026). Bing Webmaster Tools, FAQ – New AI Preferences.
OpenAI, Ułatwiamy witrynom określanie preferencji dotyczących trenowania AI (30.10.2026).
IETF, Kevin Kelley, Machine-Readable Training Preference Signal (draft-kelley-aipref-training-preference-signal-00, 30.10.2026), wiadomość na liście ai-control (30.10.2026), słownik AIPREF draft-ietf-aipref-vocab-08.
Anthropic, strona pomocy o robotach Anthropic (aktualizacja 7.04.2026). X, robots.txt (stan na 1.11.2026). Search Engine Journal, Matt G. Southern, Google, Microsoft, and OpenAI Plan to Honor a Shared AI Training Opt-Out.
