Pierwsza publikacja: 12 maja 2026 · Ostatnia aktualizacja: 14 listopada 2026
Things, not strings. Google ogłosiło tę zmianę w 2012 roku. Jest 2026, mamy AI Overviews, LLM-y, a Twoja marka wciąż może być dla algorytmu tym samym co literówka – ciągiem znaków bez tożsamości. Możesz mieć wówczas imponujące doświadczenie, ale… nie masz encji.
W skrócie
Knowledge Graph (graf wiedzy Google) to system powiązań między encjami: baza, na podstawie której Google rozumie, kto jest kim.
Knowledge Panel (panel wiedzy) to powierzchnia w wynikach wyszukiwania, na której Google pokazuje wybrane informacje o encji. Opiera się na Knowledge Graph i innych źródłach, którym Google ufa. Nie da się go „założyć” jak wizytówki.
Knowledge Graph Search API to narzędzie diagnostyczne: pokazuje, jakie encje Google zwraca dla danego zapytania, ale nie daje wglądu w cały graf.
Encja to osoba, firma, miejsce albo pojęcie, które wyszukiwarka rozpoznaje jednoznacznie. O encji osoby piszę w zapisie prelekcji o encji marki osobistej, o encji firmy we wpisie encja marki.
Czym jest Knowledge Graph?
Knowledge Graph to sieć powiązanych znaczeń. Węzłami są encje (osoby, firmy, miejsca, pojęcia), a liniami relacje między nimi:
- …pracuje w…,
- …jest autorem…,
- …specjalizuje się w…
Zaczęło się 16 maja 2012, gdy Amit Singhal, ówczesny SVP of Engineering odpowiedzialny za wyszukiwarkę Google, opublikował post, który zmienił logikę całej wyszukiwarki. Singhal od lat marzył o zbudowaniu „komputera ze Star Treka” – systemu, który nie dopasowuje fraz do stron, ale rozumie, czego szukasz.
Hasło, pod którym wystartował graf, brzmiało:
„Things, not strings”
co możemy przetłumaczyć na: znaczenia, nie ciągi znaków. Jak od tej zmiany doszliśmy do BERT-a, MUM i trybu AI, opisuję we wpisie Encja, kontekst, intencja.
| Kiedy | Encje | Fakty | Źródło |
|---|---|---|---|
| 16 maja 2012 | 500 mln obiektów | 3,5 mld | Google, start grafu |
| grudzień 2012 | 570 mln | 18 mld | Google, blog Inside Search |
| maj 2020 | 5 mld | 500 mld | Google (Danny Sullivan) |
| marzec 2024 | ponad 54 mld | 1 600 mld | szacunek Kalicube |
| czerwiec 2025 | ponad 3 mld mniej w tydzień (ok. 6% grafu) | – | analiza Kalicube |
Rozmiar grafu wiedzy Google. Liczby Google do 2020 roku, potem szacunki Kalicube.
Istotne stało się nie to, ile masz treści w indeksie, ale czy Google wie, że Ty się tym zajmujesz i czy potrafi przypisać Ci atrybuty i relacje.
Graf jest aktywnie czyszczony
Google nie tylko dodaje encje. Także je usuwa. Według analizy Kalicube w czerwcu 2025 zaobserwowano największy od dekady spadek liczby encji w Knowledge Graph: ponad 3 miliardy jednostek usunięte w ciągu jednego tygodnia (około 6% całego grafu). Jason Barnard nazwał tę zmianę „wielkim czyszczeniem na rzecz klarowności” (Great Clarity Cleanup). Dane wskazują na przesunięcie akcentu z gromadzenia na jednoznaczność: odsetek encji z jednym, precyzyjnym typem wzrósł z 24% do niemal 29%, a wieloznaczne encje typu „thing” skurczyły się o ponad 15%.
W praktyce samo bycie w grafie nie wystarczy. Encja musi być czytelna i jednoznaczna, inaczej może wypaść przy następnym czyszczeniu.
Czytelność encji nie jest stanem, który raz się osiąga i ma się z głowy.
Porządkowanie encji marki polega w praktyce na trzymaniu trzech warstw sygnałów w zgodzie ze sobą – opisuję je niżej po kolei. Dwie pierwsze da się ogarnąć samodzielnie, trzecia wymaga czasu i cudzych rąk.
Czym jest Knowledge Panel?
Większość osób, które pytają mnie o Knowledge Panel, myli go z wizytówką Google Business Profile – czymś, co się „zakłada”. Tu jednak nie ma formularza rejestracyjnego. Panel to nie Twoja deklaracja, to odpowiedź algorytmu, która pojawia się, gdy Google zebrało wystarczająco dużo spójnych sygnałów, żeby jednoznacznie Cię zidentyfikować.
| Knowledge Panel | Profil firmy (GBP) | Rich snippets | |
|---|---|---|---|
| Co to jest | Informacje o encji (osobie, firmie, pojęciu), które Google zebrało samo | Profil firmy, która obsługuje klientów w konkretnym miejscu albo na obszarze działania | Rozszerzony wynik konkretnej strony: gwiazdki ocen, ceny, przepisy |
| Kto zakłada | Nikt: pojawia się, gdy Google ma dość spójnych sygnałów. Możesz zgłosić do niego prawa | Właściciel firmy, w Profilu Firmy w Google | Właściciel strony, przez dane strukturalne |
| Skąd dane | Knowledge Graph i źródła, którym Google ufa: Wikidata, Wikipedia, wzmianki | Właściciel profilu i użytkownicy (opinie, zdjęcia) | Dane strukturalne na stronie |
| Gdzie się wyświetla | W prawej kolumnie na komputerze, między wynikami na telefonie | W wynikach lokalnych, w Mapach i w prawej kolumnie | W zwykłym wyniku tej strony |
Trzy różne rzeczy. Gdy panel wiedzy i wizytówka walczą o prawą kolumnę, sprawdź, co blokuje Knowledge Panel.
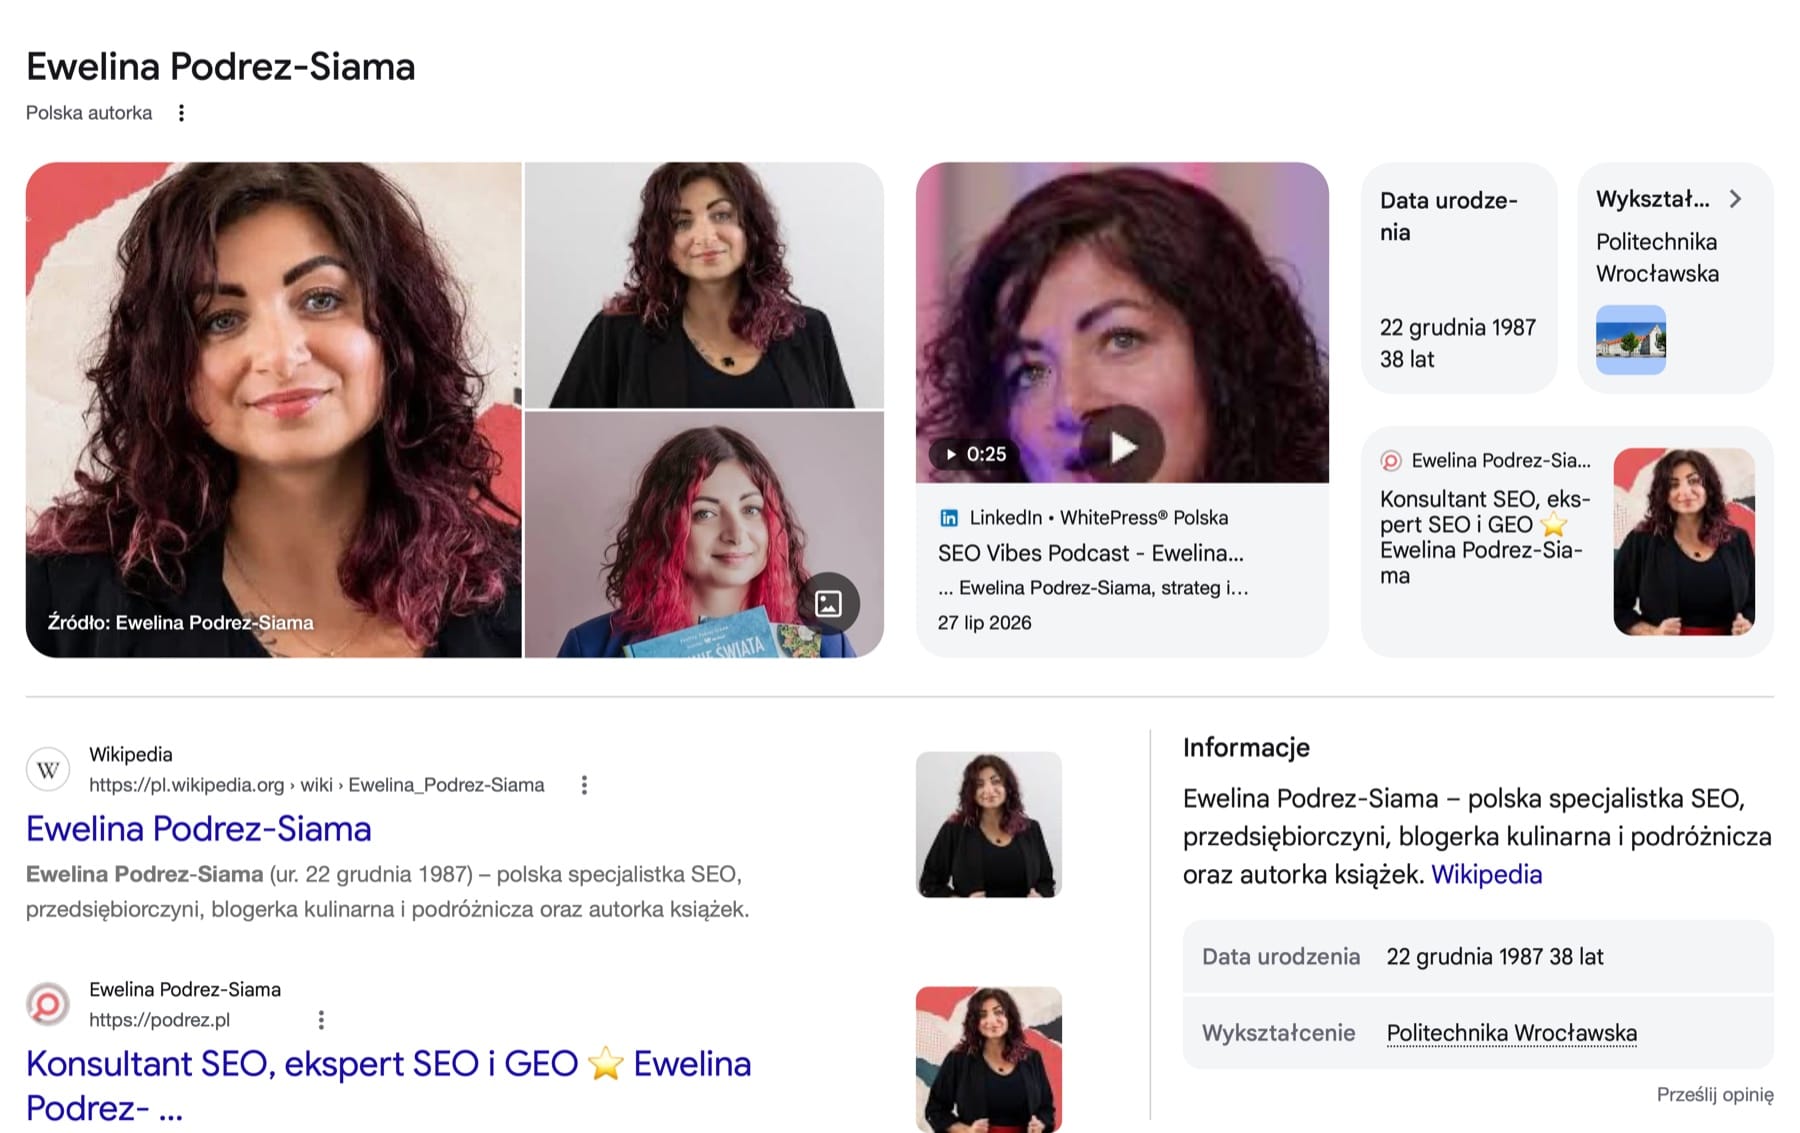
Na desktopie Knowledge Panel wyświetla się najczęściej na górze i po prawej stronie wyników wyszukiwania (na mobile może być wpleciony między wyniki). Znajduje się tam szereg elementów, w tym zdjęcie, opis, linki do profili, powiązane osoby i tematy. I to nie to samo co rich snippets (gwiazdki ocen, ceny produktów czy zdjęcia przepisów to efekt danych strukturalnych na konkretnej stronie).
Panel dotyczy encji jako całości, zbudowanej z wielu źródeł jednocześnie, jak na powyższym przykładzie: widzisz w nim opis z Wikipedii, wynik z podrez.pl i nagranie z LinkedIna.
Źródła danych panelu wiedzy
Google buduje panel przede wszystkim ze źródeł zewnętrznych, jak:
Wikidata
Otwarta baza faktów, z której Google aktywnie czerpie. Jak do niej trafić, opisuję w poradniku Wikidata krok po kroku.
Wikipedia
Treść wpisu może trafić do panelu zaskakująco szybko.
Wzmianki w mediach
Cytowania i inne niezależne źródła. Więcej o tym, jak działają, piszę przy brand mentions.
To nie jest zamknięta lista. Google deklaruje, że korzysta z setek źródeł: materiałów z sieci, otwartych i licencjonowanych baz danych oraz danych strukturalnych publikowanych przez właścicieli stron.
Jak szybko to działa? Mój Knowledge Panel pojawił się 11 godzin od uzupełnienia wpisu w Wikidata. Gdy kilka tygodni później powstał mój wpis na polskiej Wikipedii, opis z niego trafił do panelu w niecałą godzinę.
Ale co ważne: to nie jest żaden standard czasowy. Czas reakcji zależy od tego, ile spójnych sygnałów Google ma już w grafie – im więcej niezależnych potwierdzeń Twojej tożsamości (publikacje, wzmianki, cytowania), tym szybciej panel może się pojawić. Jeśli Twoja encja jest rozmyta – Google ma sygnały, tylko nie potrafi ich spiąć – uporządkowanie danych w Wikidata może być tym brakującym łącznikiem, który uruchomi panel szybciej, niż się spodziewasz. I tak było w moim przypadku. Całą historię tego procesu opisuję w podsumowaniu prezentacji na I♥Marketing 2026.
Jak zgłosić prawo do panelu wiedzy?
Jeśli masz już swój panel, wyszukaj swoje imię i nazwisko w Google albo wpisz adres google.com/search?kgmid=/g/11md2bpb8_ (zamiast mojego ID wstaw swój z Knowledge Graph API, o tym za chwilę). Dalej wygląda to tak:
- 1Znajdź panel
Wyszukaj siebie albo podmiot, który reprezentujesz. Zaloguj się na konto Google, którym chcesz zarządzać panelem.
- 2Zgłoś prawa
Według pomocy Google przycisk „Zgłoś prawo do tego panelu wiedzy” jest na dole panelu, czasem w sekcji „Informacje”, a na telefonie w menu. U mnie był w menu z trzema kropkami. Nie każdy panel da się dziś przejąć.
- 3Przejdź weryfikację
Google poprosi o zalogowanie się na jednej z oficjalnych stron lub w jednym z profili, np. YouTube albo Search Console. W moim przypadku proces obejmował także selfie z dowodem osobistym i potwierdzenie dostępu do kont social media.
- 4Sugeruj zmiany ze źródłem
Po weryfikacji możesz sugerować zmiany w panelu. Do każdej dołącz publiczne, niezależne źródło. Szczegóły niżej.

Z mojej praktyki
Zgłoszenie praw wygląda prosto, ale dziś wnioski często weryfikuje automat, który potyka się o szczegóły. Problemem bywa na przykład drugie imię w dowodzie osobistym.
Przy jednym panelu wymieniłam z supportem Google kilkanaście e-maili, a udało się dopiero po kilkunastu wnioskach. Prawa przejęłam jako reprezentantka znanej marki osobistej, a potem udostępniłam je samemu zainteresowanemu. Odrzucony wniosek nie zamyka więc sprawy.
Bywa i tak, że panel istnieje, masz do niego prawa, a na Twoje nazwisko Google i tak pokazuje coś innego. U mnie panel działał od około 2,5 miesiąca, a na frazę z moim nazwiskiem wciąż wygrywała – przynajmniej w mojej okolicy – wizytówka z Map, którą sama założyłam lata temu. Jak to sprawdziłam i dlaczego w końcu ją usunęłam, opisałam we wpisie Co blokuje Knowledge Panel?
Co, jeśli panel wyświetla błędne dane?
Jako zweryfikowany właściciel panelu masz przycisk „Sugeruj zmianę”. Ale Google nie zmieni faktów tylko dlatego, że o to poprosisz – musisz wskazać publiczne, niezależne źródło (link do wywiadu w medium, wpis w Wikidata, rejestr publiczny), które potwierdza Twoją wersję, oraz konkretny fragment tekstu z tego źródła.
To ta sama logika, która przewija się przez większość moich wpisów na blogu: algorytm bardziej ufa temu, co mówią o Tobie inni, niż temu, co sam wpisujesz w formularz.

Panel wiedzy to nie jedyna powierzchnia w wynikach, na której widać, czy Google rozumie Twoją encję. Obok niego coraz częściej pojawiają się sekcje „Więcej pytań” (People Also Ask) – pytania powiązane z Twoim nazwiskiem, generowane głównie na podstawie wzorców zapytań użytkowników.
Mechanizm jest inny niż w przypadku panelu (bliższy analizie sesji wyszukiwania niż grafowi wiedzy), ale efekt jest podobny: jeśli ktoś szuka Twojego nazwiska, PAA może wyświetlić pytania o Twoją firmę, książki, specjalizację – pod warunkiem, że Google ma z czego je zbudować.
People Also Ask: co „Więcej pytań” mówi o Twojej marce
Trzy warstwy sygnałów budujących encję
Skąd Google bierze fakty o Tobie? Z trzech niezależnych warstw. Co ciekawe, ich siła rośnie w odwrotnej proporcji do Twojej kontroli: im mniej możesz wpłynąć na źródło, tym bardziej algorytm mu ufa.
Trzy warstwy sygnałów. Im mniej możesz wpłynąć na źródło, tym bardziej algorytm mu ufa. Opracowanie własne.
Warstwa 1: dane strukturalne na Twojej stronie
Zaczynam od Twojej strony, bo to jedyne źródło, nad którym masz pełną kontrolę. I paradoksalnie najsłabsze z trzech.
Dane strukturalne to kod, w którym deklarujesz algorytmowi, kim jesteś i z czym jesteś powiązany – w formie czytelnej dla botów, niewidocznej dla użytkownika. Format: JSON-LD osadzony w kodzie strony (najczęściej w sekcji head, choć Google obsługuje też body), zgodny ze standardem schema.org.
Kluczowe właściwości typu Person dla marki osobistej:
| Właściwość | Co mówi algorytmowi |
|---|---|
sameAs | Spina Twoje profile (LinkedIn, Wikidata, social media) w jedną encję. |
knowsAbout | Definiuje, w czym się specjalizujesz. |
worksFor | Wiąże Cię z organizacją. |
alumniOf, award | Afiliacje i wyróżnienia jako dowody autorytetu. |
Gdy jesteś spójnie przypisany jako author artykułu czy książki, algorytm dostaje uporządkowaną informację o autorstwie. Dowodem ekspertyzy staje się dopiero połączenie tej deklaracji z treścią, reputacją i zewnętrznymi potwierdzeniami.
Szczególnie istotna jest rola sameAs w rozwiązywaniu problemu homonimów. Jeśli na przykład nazywasz się Krzysztof Rutkowski, jak szef działu Ads w Fox Strategy, w grafie wiedzy może istnieć wiele encji o tym samym ciągu znaków, część bardzo silnych ze względu na obecność w tabloidach.
Właściwość sameAs wiąże Twoją stronę z unikalnym identyfikatorem w Wikidata (QID), profilem LinkedIn, Twoimi pozostałymi stronami. I to te powiązania mówią algorytmowi, który Krzysztof Rutkowski to Ty. Bez nich Google widzi nazwisko. Z nimi – widzi encję.
Najsilniejszy sygnał to relacja dwustronna: Twoja strona wskazuje na profil, a profil linkuje z powrotem do strony. Jednostronne sameAs w kodzie, bez potwierdzenia z drugiej strony, to deklaracja – nie dowód.
Dane strukturalne schema w pigułce: jak wdrożyć Person
Warstwa 2: zewnętrzne bazy danych
Teraz to, nad czym masz mniejszą kontrolę. Właśnie dlatego algorytm traktuje te źródła poważniej. Search Quality Rater Guidelines – wytyczne dla osób oceniających jakość wyników (to nie bezpośredni opis algorytmu, ale ważny wskaźnik tego, jak Google definiuje zaufanie) – wprost wskazują konflikt interesów: deklaracje własne wymagają potwierdzeń z bardziej niezależnych źródeł.
Pierwsze źródło, od którego warto zacząć, to Wikidata – otwarta baza wiedzy Wikimedia Foundation z ponad 124 mln elementów (stan na 14 listopada 2026), z której korzystają m.in. badacze Google i twórcy modeli językowych. Po dane o osobach Google sięga właśnie do zewnętrznych baz.
Ważne zastrzeżenie
Wikidata nie jest katalogiem SEO
Ani miejscem do autopromocji. Wpis ma uzasadnienie tylko wtedy, gdy encja spełnia kryteria istotności projektu i można ją opisać na podstawie niezależnych, weryfikowalnych źródeł.
Społeczność Wikidata mocno odradza zakładanie elementu o sobie i sama zaznacza, że nie steruje panelami Google. Jak się w tym odnaleźć, piszę w poradniku o Wikidata.
Według analiz Kalicube: między majem 2020 a marcem 2024 liczba encji typu Person w grafie wzrosła 22-krotnie. Największy przyrost w aktualizacji z marca 2024 (38%) dotyczył ról, do których Google potrafi przypisać sygnały E-E-A-T: badaczy, pisarzy, akademików, dziennikarzy. Encje firmowe wzrosły tylko 5-krotnie.
Patent
Sygnał z działu patentów. Patent Google US12321706B2 (przyznany w czerwcu 2025) opisuje zewnętrzną pamięć modelu językowego, w eksperymentach opartą na trójkach wiedzy z Wikidata. Skąd się wziął i czego nie przesądza, rozpisuję w poradniku o Wikidata.
Warstwa 3: wzmianki i współwystępowanie encji
Trzecia warstwa jest najtrudniejsza do zbudowania. I dlatego najbardziej wartościowa.
Google może rozpoznawać, w jakim kontekście pojawia się Twoje nazwisko – także poza klasycznymi linkami. Zgłoszenie patentowe US20180046717A1 (Related Entities, 2018; samo zgłoszenie porzucono, a z tej rodziny udzielono patentu US9275152) opisuje mechanizm identyfikowania encji powiązanych z zapytaniem, m.in. na podstawie zachowań użytkowników, wyników wyszukiwania i relacji między encjami.
To nie znaczy, że każda wzmianka bez linku działa jak link. Pokazuje jednak, że relacje między encjami mogą być modelowane szerzej niż przez sam graf hiperłączy.
Cytowania w mediach branżowych, wywiady, artykuły gościnne, wzmianki na konferencjach – wszystko to buduje kontekst Twojej encji. Nie musisz mieć linku. Wystarczy, że Twoje nazwisko pojawia się w odpowiednim sąsiedztwie tematycznym, regularnie i konsekwentnie.
Brand mentions: wzmianki o marce, które wzmocnią Twoje SEO i GEO
Triangulacja autorytetu
Dane strukturalne bez Wikidata to deklaracja bez potwierdzenia. Wikidata bez wzmianek to encja bez kontekstu. Wzmianki bez danych strukturalnych to szum bez struktury.
Spójność między warstwami – te same fakty potwierdzone z trzech niezależnych kierunków – nazywam w książce Marka osobista w czasach AI i generatywnego wyszukiwania triangulacją autorytetu.
Knowledge Graph a LLM-y – dwie mapy, podobny efekt
Google ma graf wiedzy oparty na weryfikowalnych źródłach, którego wybrane elementy widzimy w panelach, wynikach i API. LLM-y budują wewnętrzne reprezentacje z danych treningowych – bez jawnej bazy, na podstawie wzorców – lub pobierają dane na bieżąco podczas websearchu (RAG). Różnica w mechanizmie, ale podobieństwo w efekcie: jeśli nie jesteś spójną encją z atrybutami i relacjami, żaden system nie zbuduje Twojej reputacji.
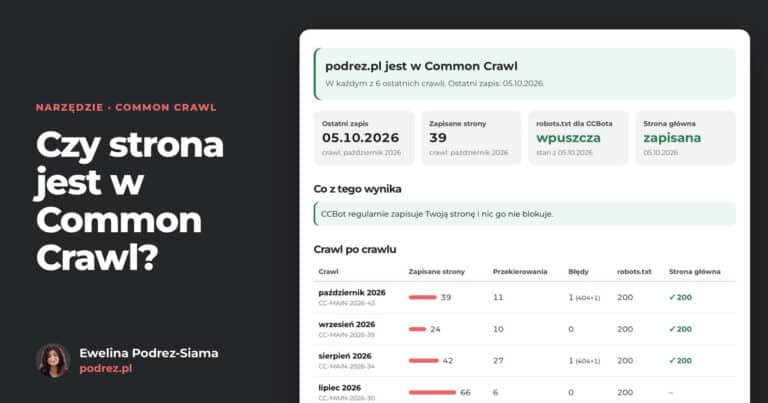
Skąd modele mają dane o Tobie? Duża część pochodzi z otwartych zbiorów stron, takich jak Common Crawl. Czy jest w nim Twoja strona, sprawdzisz w narzędziu Czy strona jest w Common Crawl?
Jak bardzo modele językowe potrafią się mylić? Raport Stanford AI Index 2026, w rozdziale o odpowiedzialnej AI, opisuje test przekonań przeprowadzony na czołowych modelach. Gdy użytkownik przedstawił fałszywe twierdzenie jako cudze przekonanie, modele radziły sobie dobrze. Ale gdy to samo twierdzenie sformułował jako własne – modele potakiwały i budowały na błędzie.
Stanford AI Index 2026, rozdział o odpowiedzialnej AI.
Dla Twojej marki to ma konkretne znaczenie: jeśli ktoś pyta LLM o Ciebie z błędnym założeniem (np. „Czy Kowalski to ten specjalista od social mediów?”), model bez twardych danych raczej potwierdzi, niż skoryguje. Grafy wiedzy redukują ten problem, bo dają modelom weryfikowalne fakty zamiast wzorców do odgadywania.
Generatywne doświadczenia Google coraz mocniej łączą modele językowe z systemami wyszukiwarki – w przypadku Trybu AI Google wprost deklaruje korzystanie m.in. z Knowledge Graph.
W AI Overviews mechanizm jest opisywany bardziej ogólnie, ale kierunek jest podobny. W moim przypadku zmiany w odpowiedziach AI Overviews były mocno zauważalne w niedługim czasie od poprawy wyniku resultScore w Knowledge Graph.
Gdy użytkownik pyta o konkretną osobę, dobrze opisana encja daje systemowi stabilniejsze punkty odniesienia: atrybuty, relacje, źródła. Jeśli ich brakuje, odpowiedź częściej opiera się na fragmentach stron znalezionych w indeksie, co daje mniejszą kontrolę nad narracją o Tobie.
Praca nad encją to nie „SEO albo AI”. To fundament widoczności w obu systemach.
Marka osobista w LLM-ach i RAG
Te narzędzia Ci się przydadzą
Pięć narzędzi, pięć funkcji: weryfikacja w surowych danych, uproszczone sprawdzenie bez konsoli, zgodność z Wikidata, wizualizacja powiązań w formie grafu i mapa tego, co deklaruje Twoja strona.
| Narzędzie | Co pokazuje | Kiedy użyć |
|---|---|---|
| Google Knowledge Graph Search API | Typ encji, opis, powiązane adresy i resultScore, czyli trafność dopasowania encji do zapytania. | Gdy chcesz zobaczyć surowe dane. Instrukcja krok po kroku: encja marki osobistej. Google przenosi API do Cloud Enterprise Knowledge Graph i pisze, że nie nadaje się ono do zastosowań krytycznych (stan na 14.11.2026). |
| Wyszukiwarka Grafu Wiedzy (WikiZEIT) | Narzędzie Jakuba T. Jankiewicza z edukacyjnego projektu WikiZEIT: wynik z Grafu Wiedzy dla wpisanej frazy. | Na start, jeśli nie masz doświadczenia z API: bez konfigurowania Google Cloud i logowania do konsoli. |
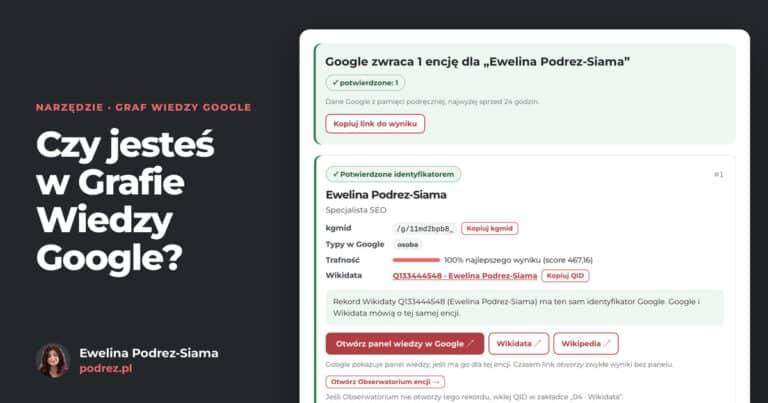
| Czy jesteś w Grafie Wiedzy Google? (podrez.pl) | resultScore, kgmid i to, czy Wikidata ma ten sam identyfikator. | Gdy chcesz sprawdzić, czy Google i Wikidata mówią o tej samej encji. Otwórz narzędzie. |
| Knowledge Graph Visualiser (Roman Rozenberger) | Encja z Wikidata jako graf: węzły, relacje, atrybuty (D3.js, open source). | Gdy chcesz zobaczyć powiązania. Tego narzędzia używam do wizualizacji własnej encji – te same grafy zobaczysz w książce. GitHub · demo |
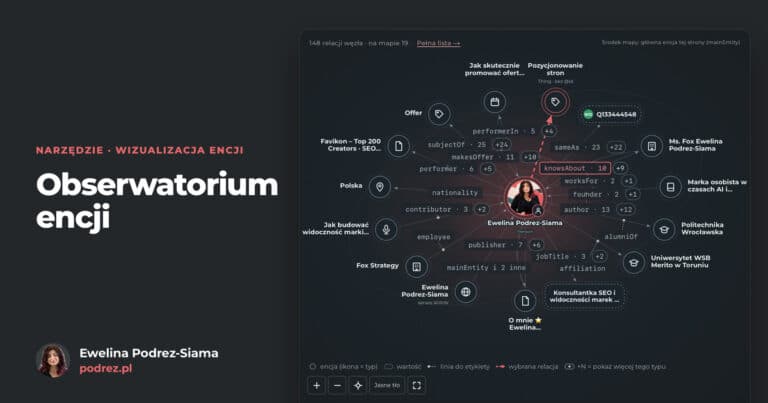
| Obserwatorium encji (podrez.pl) | To, co deklaruje Twoja strona w danych strukturalnych, obok rekordu z Wikidata. | Gdy sprawdzasz, czy sameAs prowadzi tam, gdzie trzeba. Otwórz Obserwatorium. |
Dwie rzeczy, o których warto pamiętać: identyfikator kg:/… nie gwarantuje panelu w wynikach, a unikalne nazwisko łatwiej uzyska wysoki wynik niż popularne „Jan Kowalski”, przy którym API wybiera spośród wielu encji.

Narzędzie
Czy jesteś w Grafie Wiedzy Google?
resultScore, kgmid i zgodność z Wikidata w jednym miejscu.
Narzędzie
Czy strona jest w Common Crawl?
Sprawdzisz, czy Twoja strona jest w jednym z największych otwartych zbiorów danych o sieci.

Co z tego wynika dla Twojej marki
Knowledge Graph i Knowledge Panel to warstwa, na której opiera się coraz więcej tego, co ludzie widzą, gdy szukają informacji o Tobie – w Google, w AI Overviews, w odpowiedziach modeli językowych.
Przez lata prowadziłam bloga, występowałam na konferencjach, publikowałam książki – i mimo to moja encja w Knowledge Graph była rozmyta. Nie brakowało mi treści, ale nie panowałam nad tym, jak algorytm łączy te sygnały w jedną tożsamość. Pełną historię tego procesu, z danymi i narracją każdego kroku, opisuję w książce. Tu zostawiam Ci trzy pytania, od których warto zacząć:
- 1
Czy Google wie, kim jesteś, czy tylko widzi Twoje imię?
Sprawdź resultScore w Knowledge Graph API albo w moim narzędziu. Pusty wynik lub brak identyfikatora
kg:/oznacza, że API nie zwraca dla Ciebie stabilnej, jednoznacznej encji. Wikidata to jeden z pierwszych kroków porządkowania sygnałów. - 2
Czy Twoje trzy warstwy sygnałów mówią to samo?
Dane strukturalne na stronie, wpis w Wikidata, wzmianki w sieci – jeśli schema.org mówi „strateg SEO”, a media piszą „bloger”, algorytm widzi niespójność.
- 3
Co zostanie, gdy usuniesz własne treści?
Gdyby jutro zniknęły Twoje posty, artykuły, nagrania – co wie o Tobie algorytm z niezależnych źródeł? Jeśli niewiele, masz problem z trwałością, nie z widocznością.
Onepress (Helion) · w sprzedaży od 9 czerwca 2026
Pełne case study budowania encji od zera, z konkretnymi danymi i narracją każdego kroku. Kontekst prezentacji na scenie znajdziesz w relacji z I♥Marketing 2026.
Dowiedz się więcej →Czytaj dalej
Wikidata krok po kroku: jak założyć element i co w nim wpisać
Encja marki osobistej: co Google i AI o Tobie wiedzą
Encja marki: co to jest i dlaczego to ważne
Trust Halo: gdy encja przenosi się na nowe projekty
FAQ – najczęstsze pytania o Knowledge Graph i panel wiedzy
Czy można założyć Knowledge Panel?
Nie. Panel nie ma formularza rejestracyjnego: pojawia się, gdy Google zbierze wystarczająco dużo spójnych sygnałów o encji. Możesz natomiast zgłosić prawa do istniejącego panelu i sugerować w nim zmiany. To, co się „zakłada”, to Profil Firmy w Google, czyli wizytówka.
Jak sprawdzić, czy jestem w Knowledge Graph?
Wpisz imię i nazwisko albo nazwę firmy w narzędziu Czy jesteś w Grafie Wiedzy Google? albo w Knowledge Graph Search API. Wynik z identyfikatorem kg:/… oznacza, że Google zwraca Twoją encję. Pusty wynik nie przesądza, że Cię nie zna: API pokazuje tylko część grafu.
Ile trwa, zanim pojawi się panel wiedzy?
Nie ma standardu. Mój panel pojawił się 11 godzin od uzupełnienia wpisu w Wikidata, ale czas zależy od tego, ile spójnych sygnałów Google już ma. Przy rozmytej encji uporządkowanie Wikidata bywa brakującym łącznikiem. Bez niezależnych źródeł nie pomoże.
Czym różni się panel wiedzy od wizytówki Google?
Panel wiedzy opisuje encję (osobę, firmę, pojęcie) i powstaje z danych, które Google zebrało samo. Wizytówkę (Profil Firmy w Google) zakłada właściciel firmy, która obsługuje klientów w konkretnym miejscu albo na obszarze działania. Oba mogą walczyć o prawą kolumnę wyników. Więcej w tekście o tym, co blokuje Knowledge Panel.
Jak poprawić błędne dane w panelu wiedzy?
Zgłoś prawa do panelu, a po weryfikacji użyj „Sugeruj zmianę”. Do każdej poprawki dołącz publiczne, niezależne źródło i fragment, który potwierdza Twoją wersję. Bez zweryfikowanych praw możesz wysłać sugestię przez „Opinia” pod panelem.
Danny Sullivan, A reintroduction to our Knowledge Graph and knowledge panels, Google, 20.05.2020.
Google, pomoc: weryfikacja i zgłaszanie praw do panelu wiedzy oraz panele wiedzy, odczyt 14.11.2026.
Google, Knowledge Graph Search API: dokumentacja i zapowiedź migracji do Cloud Enterprise Knowledge Graph, odczyt 14.11.2026.
Jason Barnard, Google’s great clarity cleanup, Search Engine Land, 2025; Unpacking Google’s 2024 E-E-A-T Knowledge Graph update, Search Engine Land, 2024.
Kalicube, The Knowledge Graph in Google Search.
Patent US12321706B2 „Soft knowledge prompts for language models”, 3.06.2025; zgłoszenie US20180046717A1 „Related Entities”, 2018, porzucone.
Google, Search Quality Rater Guidelines, wersja z 11.09.2025.
Stanford HAI, AI Index Report 2026 – Responsible AI.
Wikidata: statystyki API (124 057 335 elementów) i Wikidata:Self-promotion, odczyt 14.11.2026.
Chcesz częściej widzieć moje wpisy w Google?
Dodaj podrez.pl do preferowanych źródeł w GoogleWięcej w temacie: Encje i Knowledge Graph