Stan na 21 listopada 2026 · przykłady z mojego elementu w Wikidacie, z danych strukturalnych podrez.pl i z przykładowego sklepu z ekspresami
Semantyczne SEO to dbanie o to, żeby Google, ChatGPT i inne modele językowe rozumiały, o czym piszesz, a nie tylko dopasowywały do siebie słowa. Google szuka w tekście konkretnych rzeczy: osób, firm, produktów, miejsc i pojęć. Sprawdza też, co je łączy: kto co napisał, kto co produkuje, co jest częścią czego. W SEO te rzeczy nazywamy encjami, a połączenia między nimi relacjami.
Weźmy na tapet proste pytanie: „Kto napisał Markę osobistą w czasach AI?”. Żeby Google i ChatGPT mogły odpowiedzieć poprawnie, muszą wiedzieć, o którą książkę chodzi, o którą osobę i co je łączy. W tym wypadku łączy je autorstwo. Książka, autorstwo i osoba to razem trójka semantyczna.
W skrócie
Trójka semantyczna (trójka wiedzy) to jeden fakt w formie podmiot → relacja → obiekt, np. książka → autor → osoba. Każda część może mieć identyfikator: ISBN, GTIN, NIP albo numer elementu w Wikidacie.
A AI? Google podaje, że tryb AI korzysta m.in. z Knowledge Graph. Inne modele językowe uczą się faktów z tekstów i baz wiedzy. Jednoznaczny opis ułatwia im ustalenie, o którą książkę, osobę albo wersję produktu chodzi.
Czym nie jest: listą synonimów do rozsypania po tekście, choć wiele poradników tak je opisuje.
Od czego zacząć semantic SEO? Od pytania czytelnika i jednego jasnego zdania z odpowiedzią na stronie. Dane strukturalne i Wikidata pomagają potwierdzić fakty, ale nie są warunkiem koniecznym.
Czym jest semantyczne SEO?
Semantyczne SEO to optymalizacja pod znaczenie zamiast pod dopasowanie słów. Zaczynasz od czytelnika: o jaką rzecz pyta i czego chce się o niej dowiedzieć. Potem sprawdzasz, czy ze strony jasno wynika, jakie rzeczy opisuje, co o nich twierdzi i jak są ze sobą powiązane.
Semantyka: jedno słowo, trzy znaczenia
Semantyka to dział językoznawstwa, który bada znaczenie wyrazów i zdań. Ma znaczenie także w SEO, gdzie liczy się to, co tekst znaczy, a nie tylko to, z jakich słów i liter się składa.
Przykładowo „zamek” może być budynkiem, mechanizmem w drzwiach albo suwakiem w kurtce. Dopiero „zamek w Malborku” wskazuje czytelnikowi konkretny obiekt. Jasne? Wyszukiwarka szuka więc takich samych wskazówek i najlepiej radzi sobie wtedy, gdy kontekst prowadzi do jednego zamku (lub zamka, jeśli nie masz na myśli omawianej twierdzy).
Encja, atrybut, relacja
Do rozmowy o semantycznym SEO wystarczą trzy pojęcia:
- Encja to rzecz, którą da się jednoznacznie rozpoznać i odróżnić od innych: osoba, firma, produkt, miejsce, pojęcie. Coca-Cola to encja. Ewelina Podrez-Siama to encja. Zamek w Malborku to encja. „Słodki napój z czerwoną etykietą” jeszcze nie, bo pasuje do wielu napojów.
- Atrybut to cecha encji razem z jej wartością: data wydania książki, cena produktu, NIP firmy, adres sklepu.
- Relacja łączy dwie encje: książka ma autorkę, produkt ma markę, sklep należy do firmy.
Encję najłatwiej rozpoznać po identyfikatorze, bo nazwy się powtarzają i nie zawsze są jednoznaczne. Takim identyfikatorem jest ISBN książki, GTIN produktu, NIP firmy albo numer elementu w Wikidacie.
Wyszukiwanie semantyczne a semantyczne SEO
Wyszukiwanie semantyczne to działka Google: systemy, które próbują zrozumieć sens zapytania i dokumentu. W maju 2012 roku Google uruchomiło Knowledge Graph pod hasłem „things, not strings”, czyli rzeczy, a nie ciągi znaków. Dalszą historię, razem z intencją wyszukiwania, rozpisałam we wpisie Encja, kontekst i intencja, a działanie samego grafu i panelu wiedzy w tekście Knowledge Graph i Knowledge Panel.
Semantyczne SEO to już Twoja działka. Dajesz systemom treść i dane, w których rzeczy i relacje są jednoznaczne. Google rozumie coraz więcej samo, ale nie zgadnie, która z kilku osób o tym samym nazwisku napisała Twoją książkę.
Semantyczne SEO a semantyczny HTML
Semantyczny HTML to inny temat o podobnej nazwie. Chodzi w nim o znaczniki, które mówią przeglądarce i czytnikom ekranu, czym jest dany fragment strony: <header>, <nav>, <article> czy <h2> zamiast samych <div>. Poprawia dostępność i porządkuje dokument, ale opisuje budowę strony, a nie rzeczy ze świata, o których strona mówi. Semantyczne SEO zajmuje się encjami i relacjami.
Co to jest trójka semantyczna?
Definicja
Trójka semantyczna (ang. semantic triple), nazywana też trójką wiedzy albo trójką RDF, to zapis jednego faktu w trzech częściach: podmiot, relacja (predykat) i obiekt.
Trochę jak szkolny rozbiór zdania. W zdaniu „Ewelina napisała książkę” podmiotem jest „Ewelina”, orzeczeniem „napisała”, a dopełnieniem „książkę”. Tyle że w trójce każda część może mieć identyfikator, a relacja pochodzi z ustalonego słownika.
Obiektem trójki może być inna encja (np. autorka) albo wartość (np. data wydania). Taka trójka to podstawowa jednostka danych w standardzie RDF organizacji W3C. Zbiór trójek tworzy graf: podmioty i obiekty są w nim węzłami, a relacje strzałkami.
Wikidata zapisuje fakty podobnie, tylko w bogatszy sposób. Stwierdzenie składa się z właściwości i wartości przypiętych do elementu, a do tego może mieć kwalifikatory (np. od kiedy coś obowiązuje) i przypisy (referencje), czyli źródła. Identyfikator elementu zaczyna się od Q, właściwości od P.
Jeden fakt w trzech miejscach: moja książka
Napisałam książkę „Marka osobista w czasach AI i generatywnego wyszukiwania”. Zobacz, jak ten fakt wygląda na mojej stronie, w danych strukturalnych i w Wikidacie.
Ten sam fakt w trzech zapisach. Dane z podrez.pl/o-mnie/ i z Wikidaty, odczyt 19 listopada 2026. Opracowanie własne.
Strona mówi o tym ludziom. Schema.org mówi to samo maszynom, ale wciąż na mojej domenie, a Wikidata zapisuje ten fakt poza nią. W obu zapisach dla maszyn książka ma autorkę, a obok nazw stoją te same identyfikatory: Q140363900 dla książki i Q133444548 dla mnie (w schema.org podane przez sameAs). Dzięki nim nie trzeba zgadywać, o którą książkę i o którą Ewelinę chodzi.
Tak zapisuję autorstwo w danych strukturalnych podrez.pl (w uproszczeniu):
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Book",
      "@id": "https://podrez.pl/#book_marka_osobista",
      "name": "Marka osobista w czasach AI i generatywnego wyszukiwania",
      "isbn": "978-83-289-3727-7",
      "author": {
        "@id": "https://podrez.pl/#person"
      },
      "sameAs": "https://www.wikidata.org/wiki/Q140363900"
    },
    {
      "@type": "Person",
      "@id": "https://podrez.pl/#person",
      "name": "Ewelina Podrez-Siama",
      "sameAs": [
        "https://www.wikidata.org/wiki/Q133444548"
      ]
    }
  ]
}
Dane strukturalne mają opisywać to, co widać na stronie. Dlatego autorstwo książki stoi też w zwykłym tekście na stronie O mnie.
Rodzaj relacji ma znaczenie
W moim elemencie w Wikidacie te same dwie encje łączy też inna relacja: Q133444548 → P800 (znaczące dzieła) → Q140363900. Wygląda podobnie, ale mówi co innego. „Ewelina napisała tę książkę” to autorstwo. „Ta książka należy do znaczących dzieł Eweliny” to ocena, co w dorobku jest ważne. Dokładnym odpowiednikiem author ze schema.org jest P50 w elemencie książki, a nie P800 w moim. Zanim wybierzesz właściwość, przeczytaj jej opis i przykłady użycia (np. Property:P50). W sklepie to samo dotyczy brand i manufacturer: marka na etykiecie i producent to nie zawsze ta sama firma.
Dlaczego trójka jest jednoznaczna, a zdanie nie
Sens zdania zależy od gramatyki, kontekstu i tego, czy czytelnik zna nazwy. „Książka Podrez” może oznaczać jedną z siedmiu moich publikacji. Trójka z identyfikatorami nie ma tego problemu: Q140363900 to jedna konkretna książka, a /g/11md2bpb8_ to dokładnie jeden węzeł w Grafie Wiedzy Google, czyli ja. Jeśli Twoja encja ma identyfikator w Grafie Wiedzy (sprawdzisz to w narzędziu Czy jesteś w Grafie Wiedzy Google?), możesz dopisać go w Wikidacie we właściwości P2671. U mnie jest tam właśnie /g/11md2bpb8_.
Jak zapisać encję osoby albo firmy
Jeden stały @id na całą domenę
Osoba albo firma powinna mieć w danych strukturalnych jeden węzeł ze stałym @id, wspólny dla całej domeny. Wpisy, oferty i strona O mnie wskazują wtedy na ten sam węzeł, zamiast za każdym razem opisywać kogoś od nowa. W sameAs podaj tylko profile, które naprawdę opisują tę osobę albo firmę, a przy wieloznacznym temacie w knowsAbout dodaj identyfikator z Wikidaty. U mnie to https://podrez.pl/#person z sameAs do Wikidaty, Grafu Wiedzy Google, ORCID i VIAF. Przy temacie „SEO” identyfikator wskazuje, które pojęcie mam na myśli.
Od czego zacząć z danymi strukturalnymi, piszę w poradniku Schema.org w pigułce, a jak tę samą logikę przenieść na firmę, we wpisie Encja marki.
Wikidata: stwierdzenie bez przypisu niczego nie dokumentuje
Przy każdym stwierdzeniu, które ma potwierdzać fakt, dodaj przypis do źródła, które każdy może otworzyć: katalogu wydawcy, rejestru, strony organizatora.
Relacje jako graf
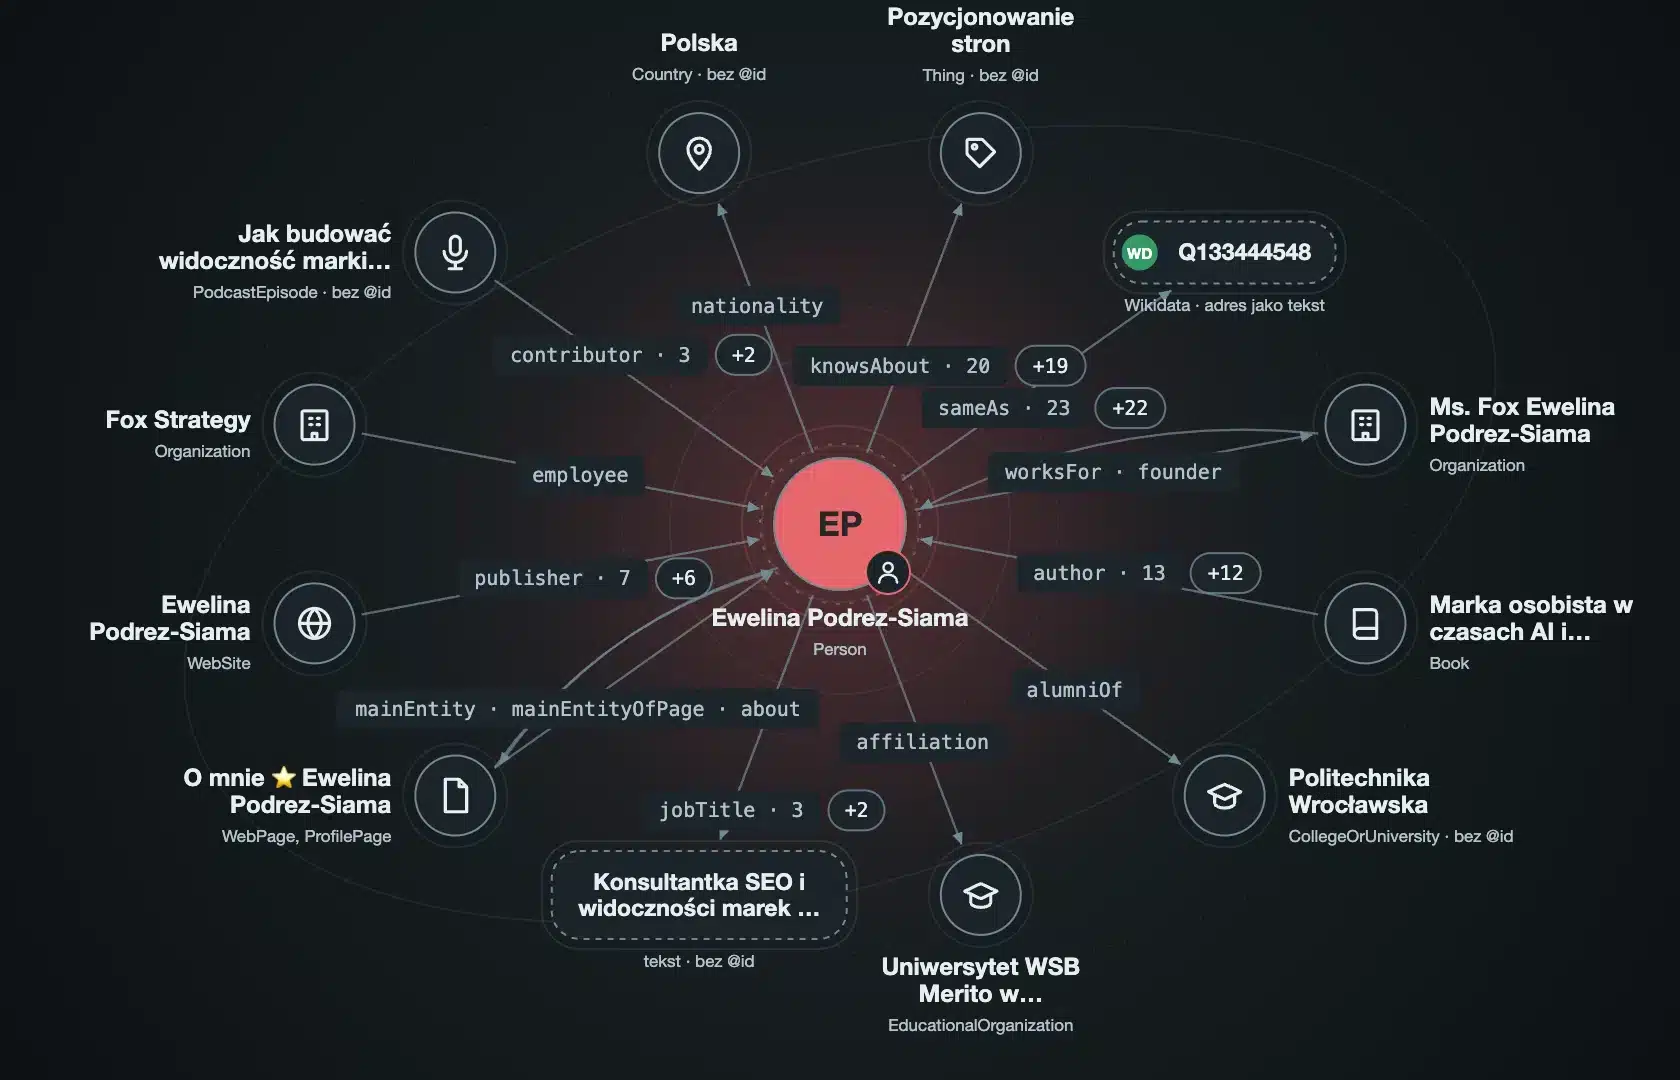
Trójki wiedzy najłatwiej zrozumieć, gdy się je zobaczy. Obserwatorium encji czyta dane strukturalne strony albo element z Wikidaty i rysuje je jako graf: strzałka biegnie od podmiotu do obiektu i jest podpisana nazwą relacji. Na mapie sprawdź, czy strzałki z różnych podstron prowadzą do jednego węzła osoby albo firmy, a nie do kilku jego kopii. Na zrzucie poniżej jest moja strona O mnie.
Semantyczne SEO a AI
Encje w AI Overviews i trybie AI
Google podaje, że tryb AI korzysta m.in. z Knowledge Graph (zapowiedź trybu AI, marzec 2025). Funkcje AI w wyszukiwarce mogą też rozbić pytanie na kilka powiązanych wyszukiwań (query fan-out) i zebrać do odpowiedzi strony o różnych podtematach. Jak to wygląda w Polsce, opisuję we wpisie Tryb AI w Google.
Moja hipoteza brzmi: fan-out pyta o konkretne rzeczy i ich cechy. Gdy strona jasno nazywa encje i podaje ich atrybuty, więcej jej fragmentów pasuje do takich wyszukiwań.
Trójki w modelach językowych
Trójki da się przełożyć na zwykły tekst dla modeli językowych. W projekcie KELM badacze Google zamienili ok. 45 mln trójek z Wikidaty na ok. 18 mln zdań. Dodali je do zbioru tekstów, który przeszukiwał model REALM (wcześniej była w nim tylko Wikipedia). Potem sprawdzili, jak trafnie model odpowiada na pytania o fakty. Lepiej wypadły zdania zbudowane z trójek niż same trójki sklejone w ciąg.
To badanie nie dowodzi, że Google używa tego w wyszukiwarce. Więcej badań i patent Google o trójkach z Wikidaty jako danych treningowych zebrałam w poradniku Wikidata krok po kroku. Jak modele łączą pamięć z wyszukanymi stronami, opisuję we wpisie Marka w LLM-ach.
Poza pamięcią z treningu tryb AI i wyszukiwanie w ChatGPT sięgają na bieżąco do wyników wyszukiwania. OpenAI pisze, że ChatGPT zwykle przepisuje pytanie na jedno albo kilka zapytań i wysyła je do partnerów wyszukiwania. Oba systemy mogą korzystać z wybranych fragmentów znalezionych stron i wskazywać źródła w odpowiedzi. Dlatego liczy się, czy pojedynczy fragment jest zrozumiały bez reszty tekstu.
Co to zmienia w treści
Jeden fakt, jedno zdanie
Kto, co i kiedy, bez rozbijania na kilka zdań. Fragment wyjęty z tekstu do odpowiedzi AI ma się bronić bez akapitu obok.
Te same fakty wszędzie
Strona, dane strukturalne, profile, Wikidata, feed produktowy. Gdy w dwóch miejscach są różne liczby albo daty, AI może powtórzyć każdą z nich.
Identyfikatory zamiast opisów
„Nasz flagowy model” nic maszynie nie mówi, numer modelu i GTIN już tak.
Źródła poza stroną
Fakt, który potwierdzają niezależne źródła, łatwiej sprawdzić niż taki, który jest tylko u Ciebie. Więcej o tym piszę we wpisie GEO vs SEO.
Semantyczne SEO w dużym serwisie
Jedną książkę sprawdzisz ręcznie. Sklep z 20 tysiącami produktów ma setki tysięcy takich faktów i nikt nie będzie ich poprawiał pojedynczo. W dużym serwisie semantyczne SEO opiera się na szablonach, danych z bazy i zasadach linkowania. Weźmy sklep z ekspresami do kawy.
Mapa encji serwisu
Zacznij od listy rzeczy, które sklep opisuje, oraz relacji między nimi. Dla ekspresów do kawy może to wyglądać tak:
| Podmiot | Relacja | Obiekt |
|---|---|---|
| Ekspres (model) | ma markę | marka (strona marki w sklepie) |
| Ekspres (model) | należy do kategorii | ekspresy kolbowe |
| Wariant (kolor, pojemność) | jest wersją | modelu ekspresu |
| Ekspres (model) | ma akcesoria | młynek, filtr, odkamieniacz |
| Poradnik | opisuje | kategorię i konkretne modele |
| Sklep | należy do | firmy (NIP, adres) |
Dla każdego rodzaju encji ustalasz, która strona jest jej „domem” (karta produktu, strona marki, kategoria), po jakim identyfikatorze ją rozpoznajesz i jakie atrybuty są obowiązkowe. Strona marki w sklepie nie musi być tylko listą produktów. To dobre miejsce na encję marki.
Dane strukturalne z szablonów
W sklepie dane strukturalne powstają z szablonu i pól w bazie. Błąd w szablonie powiela się więc na tysiącach stron, ale poprawka też.
- Produkt z identyfikatorem. Google zaleca podać wszystkie identyfikatory globalne, jakie ma produkt (GTIN, a przy książkach ISBN), do tego markę (
brand) i kod producenta albo sklepu (mpn,sku). - Warianty jako grupa. Kolory i pojemności tego samego modelu łączy
ProductGroup(zhasVariant,variesByiproductGroupID). Wtedy wersje nie udają osobnych produktów. - Firma z identyfikatorami.
Organizationsklepu zsameAsdo profili firmy i z identyfikatorami, takimi jak NIP wvatIDalbotaxID. Google pisze, że część właściwościOrganization, np.iso6523Codealbonaics, pomaga mu odróżnić Twoją firmę od innych. NIP podaj też w widocznej treści, np. w stopce albo na stronie kontaktu. - Stały @id dla marki i firmy. Każda karta produktu podaje ten sam @id marki i firmy, a przy nim co najmniej nazwę. Google czyta dane z każdej strony osobno, więc sam odnośnik do węzła z innej podstrony mu nie wystarczy.
Linkowanie według relacji
Relacje widać też w linkach. Karta produktu linkuje do marki, kategorii i pasujących akcesoriów. Poradnik prowadzi do modeli, o których mówi, a strona marki do jej linii produktów. W anchorze stoi nazwa rzeczy („młynki do espresso”), a nie „kliknij tutaj” albo doklejona fraza. Więcej o układaniu takich połączeń piszę we wpisie Topical authority i klastry tematyczne.
Spójność i kontrola na próbce stron
Ten sam produkt jest zwykle opisany w kilku miejscach: na karcie produktu, w danych strukturalnych, w feedzie Merchant Center, w porównywarkach i na marketplace’ach. Gdy w jednym miejscu jest inna nazwa, cena albo GTIN, maszyny dostają sprzeczne fakty.
Weź ekspres w wersji czarnej i srebrnej. Każdy wariant ma własny GTIN, a oba należą do tej samej grupy ProductGroup. Gdy oba warianty są na jednej stronie, znaczniki nie zmieniają się po wyborze koloru, więc od razu muszą opisać każdy wariant z jego GTIN-em. Błąd pojawia się, gdy szablon wstawia do obu wariantów GTIN wersji domyślnej. Wtedy w JSON-LD srebrny ekspres ma numer czarnego.
Z takich danych produktowych Google buduje Shopping Graph (według Google ponad 60 mld ofert, maj 2026), a zakupy w trybie AI opierają się na Gemini połączonym właśnie z tym grafem. W dokumentacji o funkcjach AI Google radzi też dbać o aktualne dane w Merchant Center i w Profilu Firmy.
Nie sprawdzasz 20 tysięcy kart. Bierzesz po kilka adresów z każdego szablonu (produkt, wariant, kategoria, marka, poradnik) i porównujesz nazwę, GTIN i markę na karcie, w JSON-LD i w feedzie. Błąd w szablonie zwykle powtarza się na każdej stronie, która z niego powstaje, więc kilka adresów wystarczy, żeby go zauważyć. Wymagania Google sprawdzisz w Teście wyników z elementami rozszerzonymi i w raportach Search Console dla fragmentów produktów i informacji o sprzedawcy, a relacje między węzłami zobaczysz w Obserwatorium encji.
Mapę encji i dane strukturalne dla sklepów i marek wdrażam w ramach usługi Entity SEO.
Semantyczne słowa kluczowe: co zebrać przed pisaniem
„Semantyczne słowa kluczowe” to nie synonimy, które trzeba upchnąć w tekście. Nie są nimi też „słowa LSI”. John Mueller z Google napisał w lipcu 2019 roku wprost: „There’s no such thing as LSI keywords”. Słownictwo z danej dziedziny pojawi się w dobrym tekście samo. Zamiast liczyć słowa, przed pisaniem zbierz:
Rzeczy, bez których temat nie istnieje
Dla tego wpisu: Google, Knowledge Graph, Wikidata, schema.org, encja, trójka.
Atrybuty, o które ludzie pytają
Dla książki: autorka, wydawnictwo, rok, ISBN. Dla ekspresu: ciśnienie, pojemność zbiornika, wbudowany młynek, cena.
Relacje, które łączą te rzeczy
Kto co napisał, co pasuje do czego, co jest częścią czego.
Pytania
Z sekcji „Podobne pytania”, podpowiedzi i zapytań w Search Console. Pokazują, które atrybuty i relacje są dla ludzi ważne.
Pojęcia z zerowym wolumenem w Ahrefsie
„Trójka semantyczna” ma w Polsce 0 wyszukiwań miesięcznie (Ahrefs, listopad 2026). Mimo to bez niej trudno wyjaśnić ten temat.
Podpowiedzi z modelu językowego, ale sprawdzone
ChatGPT czy Gemini szybko wypiszą encje, atrybuty i relacje dla tematu. Traktuj to jak burzę mózgów: fakty potwierdzasz w Wikidacie albo w Grafie Wiedzy, bo model potrafi je zmyślić.
Z tak zebranych „semantycznych słów kluczowych” układasz sekcje tekstu, linki i dane strukturalne. Powtórzeń nie liczysz wcale.
Semantyczne SEO w praktyce: 6 kroków
Te same kroki działają przy jednej książce i przy sklepie z tysiącami kart.
- 1Zacznij od pytania czytelnika
O jaką rzecz pyta i co chce o niej wiedzieć? Jedna strona, jedna główna rzecz: osoba, firma, usługa, produkt, pojęcie.
- 2Pisz relacje wprost
„Książka ukazała się 9 czerwca 2026” mówi więcej niż „nasza najnowsza publikacja”. Krótkie zdanie, z którego widać rzecz, relację i wartość, to gotowa trójka.
- 3Zapisz je w schema.org z @id i sameAs
Stały @id dla każdej ważnej rzeczy na stronie, sameAs do Wikidaty, Wikipedii albo bazy branżowej, jeśli dana rzecz ma tam wpis. W dużym serwisie robisz to raz, w szablonie. Wybierz relację, która mówi dokładnie to, co masz na myśli. Pamiętasz P50 i P800?
- 4Potwierdź je poza stroną
Wikidata z przypisami (jeśli spełniasz jej wymogi), bazy branżowe, rejestry, wzmianki w mediach. Na własnej stronie każdy może napisać o sobie, co chce. Dla książki takim źródłem jest katalog wydawcy albo Biblioteki Narodowej, dla firmy KRS albo CEIDG, dla produktu strona producenta.
- 5Linkuj według relacji, nie według fraz
Wpis o książce linkuje do autorki, produkt do marki i akcesoriów, pojęcie do szerszego tematu.
- 6Sprawdź, co widzą maszyny
Test wyników z elementami rozszerzonymi pokaże, czy Google odczytuje Twoje znaczniki. Obserwatorium encji narysuje relacje w Twoich danych, a narzędzie Czy jesteś w Grafie Wiedzy Google? sprawdzi, czy Google łączy Twoją nazwę z encją.
Czego semantyczne SEO nie załatwi
Przy semantycznym SEO łatwo obiecać za dużo. Tych rzeczy nie załatwi.
Dane strukturalne nie podniosą pozycji same
Google pisze wprost, że nie są ogólnym czynnikiem rankingowym. Pomagają mu za to zrozumieć stronę i kwalifikują ją do wyników rozszerzonych.
Knowledge Graph nie przyjmuje zgłoszeń
Panel wiedzy pojawia się, gdy Google uzna encję za dobrze potwierdzoną. Z mojego doświadczenia pomaga w tym Wikidata. Istniejący panel możesz przejąć i zgłaszać do niego poprawki.
Search Console nie ma raportu encji
Stan na 20 listopada 2026: nie znajdziesz tam też filtra dla encji ani dla Knowledge Graph. Mierzysz to inaczej: przez Knowledge Graph Search API, odpowiedzi AI i własne narzędzia.
Nie ma znacznika „pod AI”
Według Google, żeby pojawić się w funkcjach AI w wyszukiwarce, nie trzeba specjalnych danych strukturalnych. Zostają te same podstawy co w zwykłym SEO. Od siebie dodaję potwierdzenia z zewnątrz.
Jedna rzecz do zrobienia na podstawie tego wpisu
Wybierz jeden fakt o sobie, o swojej firmie albo o produkcie, na przykład autorstwo książki albo markę ekspresu. Sprawdź, czy strona, dane strukturalne i źródła zewnętrzne mówią o tym samym fakcie i czy identyfikatory wskazują właściwą książkę, osobę albo wersję produktu.
Najczęstsze pytania
Czym semantyczne SEO różni się od klasycznego SEO?
Klasyczne SEO często zaczyna od frazy i strony pod tę frazę. Semantyczne SEO zaczyna od rzeczy i relacji: o czym jest strona, z czym się łączy i jak to potwierdzić. Technika, treść i linki dalej są potrzebne, a semantyczne SEO porządkuje to, co na nich budujesz.
Czy słowa kluczowe LSI działają?
Nie jako mechanizm Google. John Mueller z Google napisał w lipcu 2019, że słów kluczowych LSI nie ma. LSI to metoda wyszukiwania informacji z lat 1988–1990 (Bellcore), testowana na małych zbiorach dokumentów. Słownictwo z danej dziedziny pojawi się w dobrym tekście samo, ale jego liczenie nie poprawia pozycji.
Jak znaleźć semantyczne słowa kluczowe?
Zrób mapę encji zamiast listy synonimów. Zbierz rzeczy, bez których temat nie istnieje, a do tego ich atrybuty (np. autor, cena, rok) i relacje między nimi. Pytania ludzi znajdziesz w sekcji „Podobne pytania”, w podpowiedziach i w zapytaniach z Search Console, a listę typowych atrybutów we właściwościach podobnych elementów w Wikidacie.
Jak wdrożyć semantyczne SEO w sklepie internetowym?
Zacznij od mapy encji: produkty, warianty, marki, kategorie i firma. Potem popraw szablony: dane strukturalne produktu z GTIN i marką, warianty połączone w grupę, stały @id dla marki i firmy. Na koniec ułóż linkowanie według relacji i na kilku adresach z każdego szablonu sprawdź, czy dane są spójne, także z Merchant Center.
Czy potrzebuję wpisu w Wikidacie, żeby robić semantyczne SEO?
Nie. Zaczynasz od własnej strony: w treści jasno nazywasz rzeczy, o których piszesz, a w danych strukturalnych zapisujesz relacje między nimi. Wikidata pomaga potwierdzić fakty poza stroną, ale wymaga poważnych, publicznie dostępnych źródeł. Nie każda osoba czy firma je ma i wtedy tę rolę pełnią bazy branżowe, rejestry i wzmianki w mediach.
Czy dane strukturalne poprawiają pozycje?
Same w sobie nie. Google pisze, że dane strukturalne nie są ogólnym czynnikiem rankingowym. Pomagają za to Google zrozumieć stronę i kwalifikują ją do wyników rozszerzonych.
Czy semantyczne SEO działa w ChatGPT i AI Overviews?
Do AI Overviews i trybu AI według Google stosuje się te same zasady SEO co do zwykłych wyników. Google podaje też, że tryb AI korzysta m.in. z Knowledge Graph. Modele językowe uczą się faktów z tekstów i baz wiedzy. Spójny zapis faktu na stronie, w danych strukturalnych i w źródłach zewnętrznych ułatwia ustalenie, o którą rzecz chodzi. Czy to zmienia odpowiedzi, musisz sprawdzić osobno w ChatGPT, w trybie AI i w każdym innym systemie.
Wikidata, Property:P50 i Property:P800, odczyt 19.11.2026.
Wikidata, Help:Statements, odczyt 19.11.2026.
W3C, RDF 1.1 Concepts and Abstract Syntax, 25.02.2014.
Siamak Shakeri, Oshin Agarwal, Google Research, KELM: Integrating Knowledge Graphs with Language Model Pre-training Corpora, 20.05.2021.
Knowledge Graph Based Synthetic Corpus Generation for Knowledge-Enhanced Language Model Pre-training, NAACL 2021, arXiv 2010.12688.
Patent US12321706B2 Soft knowledge prompts for language models, Google LLC, 3.06.2025.
Amit Singhal, Google, Introducing the Knowledge Graph: things, not strings, 16.05.2012.
Patent US4839853 Computer information retrieval using latent semantic structure, Bell Communications Research, 13.06.1989.
Search Engine Roundtable, Google: There Is No Such Thing As LSI Keywords (wpis Johna Muellera), 31.07.2019.
Google, Knowledge Graph Search API: dokumentacja v1, odczyt 19.11.2026.
Google Search Central, Introduction to structured data markup, odczyt 19.11.2026.
Daniel Waisberg, Google Search Central, Rich Results and Search Console, 11.08.2020.
Google Search Central, AI features and your website, odczyt 19.11.2026.
Robby Stein, Google, Expanding AI Overviews and introducing AI Mode, 5.03.2025.
OpenAI, ChatGPT search (pomoc), odczyt 21.11.2026.
MDN, Semantics, odczyt 19.11.2026.
Google Search Central, Merchant listing structured data i Product variant structured data, odczyt 20.11.2026.
Google Search Central, Organization structured data, odczyt 20.11.2026.
Google Search Central, General structured data guidelines, odczyt 20.11.2026.
Google, wpis o Shopping Graph (ponad 60 mld ofert), 19.05.2026.
Google, zakupy w trybie AI z Shopping Graph, 20.05.2025.
Dane własne: dane strukturalne podrez.pl (odczyt 19.11.2026).
Chcesz częściej widzieć moje wpisy w Google?
Dodaj podrez.pl do preferowanych źródeł w Google